A Inteligência Artificial é provavelmente o tema mais popular no mundo da tecnologia neste momento.
Há produtos baseados em IA a tornarem-se unicórnios ou a conseguirem centenas de milhões em financiamento de capital de risco. Há também líderes de produto famosos que lideram estes produtos baseados em IA e que seguimos e com os quais aprendemos.
Muitos gestores de produto querem beneficiar desta tecnologia incrível, quer liderando um produto de IA, quer adicionando capacidades de IA aos seus produtos existentes. Se é uma dessas pessoas, este artigo é para si.
Criei vários produtos de IA e estou aqui para o ajudar a compreender esta tecnologia e a tirar o máximo partido dela.
O que é a aprendizagem automática?
A aprendizagem automática é uma área que se concentra na criação de algoritmos e software capazes de “aprender” com a informação que fornecemos e de executar eficazmente determinados tipos de tarefas como resultado deste treino.
O termo e a própria área são surpreendentemente antigos — remontam a 1959, quando Arthur Samuel, da IBM (um dos principais cientistas informáticos da época), o cunhou no seu trabalho "Alguns estudos sobre aprendizagem automática utilizando o jogo das damas."
Apesar dos seus 60 anos de história, a aprendizagem automática só se tornou popular durante a última década, graças ao enorme aumento do poder computacional, especialmente nas GPUs.
Mas o que tem a aprendizagem automática a ver com a inteligência artificial? Vamos esclarecer isso antes de avançarmos.
Aprendizagem automática (ML) vs inteligência artificial (IA)
Toda a gente usa os termos “aprendizagem automática” e “inteligência artificial” indistintamente para se referir a software inteligente capaz de reconhecer elementos em imagens, escrever poemas e gerar respostas impressionantes a instruções detalhadas.
No entanto, a inteligência artificial é o conceito mais abrangente de máquinas com capacidades de perceção e raciocínio, enquanto a aprendizagem automática é um subconjunto da IA que se concentra em software capaz de aprender.
Agora que já esclarecemos as definições dos termos, vamos compreender como estas máquinas aprendem e quais são os princípios essenciais do seu funcionamento.
Como funciona a aprendizagem automática
Para compreender a aprendizagem automática, devemos começar por rever a sua forma mais comum — as redes neuronais de aprendizagem profunda.
Uma rede neuronal é uma estrutura escrita em código convencional que tenta replicar o funcionamento de um cérebro biológico. Nos seres humanos e noutras criaturas vivas, o cérebro é uma rede complexa de neurónios (células nervosas) ligados uns aos outros, na qual um impulso de uma célula ativa outra e a informação percorre a rede de neurónios.
Não me parece que seja a pessoa certa para explicar biologia (pois iria falhar redondamente), por isso vou cingir-me à tecnologia.
As redes neuronais em software têm um aspeto semelhante a este:
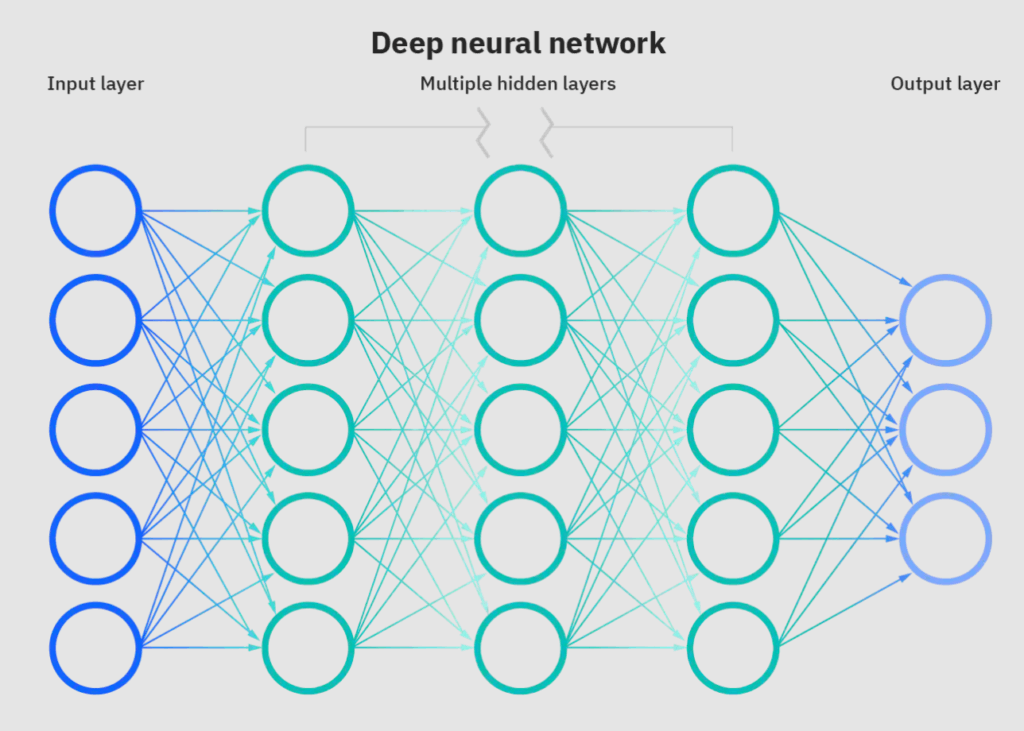
Cada círculo representa aqui um único neurónio. Em código, um neurónio é simplesmente uma função que pode consumir algum tipo de informação, processá-la e passar um resultado ao neurónio seguinte.
Nota: isto é uma simplificação do processo real. Para obter mais detalhes, pode ver a excecional videoaula sobre redes neuronais no canal do YouTube 3blue1brown, onde também explicam os conceitos matemáticos subjacentes a esta tecnologia.
Como podemos ver na imagem acima, os nossos neurónios estão organizados em camadas. As redes neuronais têm normalmente três tipos de camadas:
- A camada de entrada, responsável por receber informação do mundo exterior.
- As camadas ocultas processam esta informação, sendo que cada uma processa um único aspeto da mesma.
- A camada de saída devolve o resultado processado ao mundo exterior.
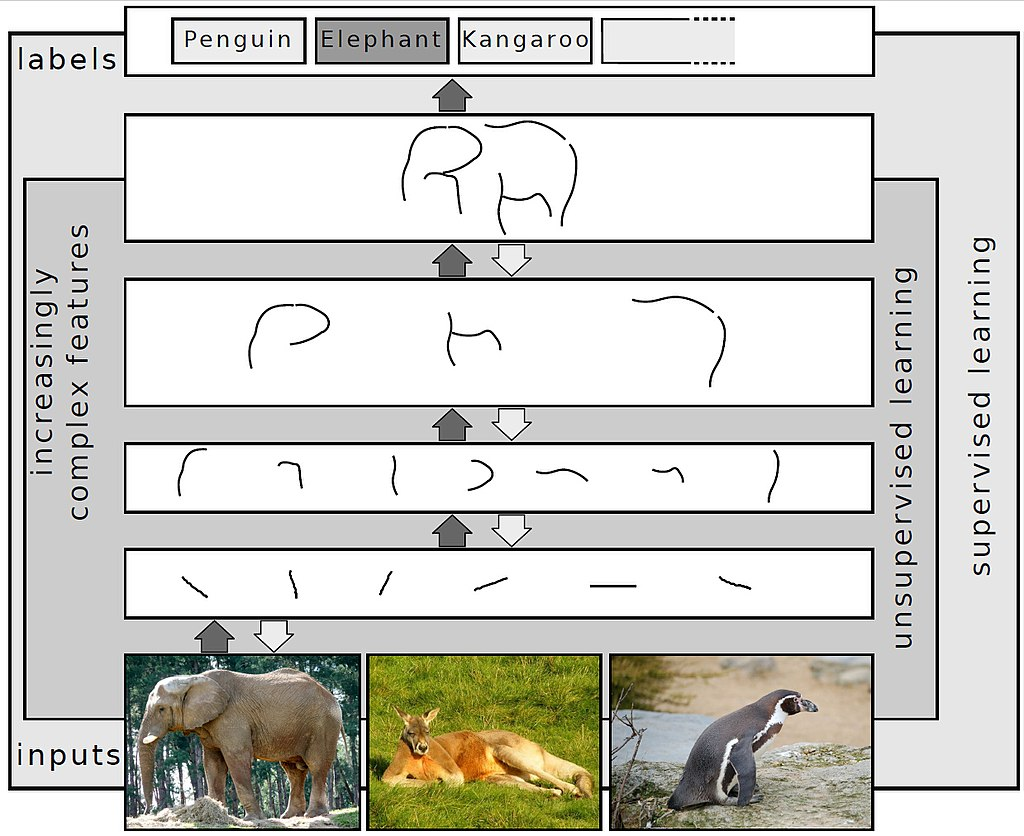
Agora vamos compreender o significado destas camadas através de um exemplo simples. Imagine que quer que a rede neuronal reconheça um animal numa fotografia. Para isso, concebeu uma rede neuronal constituída por seis camadas que funcionarão da seguinte forma:
- Camada de entrada que irá receber pequenos segmentos da fotografia do animal e passá-los à primeira camada oculta.
- A primeira camada oculta tentará encontrar formas básicas (por exemplo, linhas retas) em cada segmento e passará essa informação à segunda camada.
- A segunda camada combinará então algumas dessas linhas em formas geométricas básicas (por exemplo, círculos, semicírculos, etc.) e passá-las-á à terceira camada.
- A terceira camada criará então formas mais complexas a partir dessas formas geométricas.
- A quarta camada combinará todas as formas criadas anteriormente e obterá o contorno de um animal.
- A camada de saída, por fim, indicará o tipo de animal que reconheceu a partir da forma.
Eis o aspeto que terá visualmente.
Ao observar o processo acima, poderá perguntar-se como é que os engenheiros de IA fazem com que estas camadas reconheçam formas e adivinhem o animal na imagem, certo? Fazem-no através do “treino” da rede neuronal para executar a sua tarefa.
Para treinar a rede, os engenheiros de IA fornecem-lhe um conjunto de entradas juntamente com as respetivas saídas corretas. No nosso caso, seriam várias imagens de animais como entradas e essas mesmas imagens com o tipo correto de animal como saídas.
Como a sua rede dispõe das respostas corretas, irá ajustar-se continuamente (os parâmetros que cada neurónio transmite aos outros) até que as suas respostas sejam muito semelhantes às respostas corretas que fornecemos.
Na vida real, a sua rede nunca será 100% precisa nas suas respostas e haverá sempre algum grau de erro que terá de considerar. A boa notícia é que, na realidade, não pretende que seja 100% correta. O que lhe interessa é que o modelo seja mais rápido e mais preciso do que um ser humano.
Agora que compreendemos como funciona, vamos avançar para perceber como pode utilizar a aprendizagem automática nos seus produtos.
Aprendizagem automática: o que pode fazer e o que não pode
O entusiasmo em torno da IA é absolutamente enorme e muitos fundadores de startups ou gestores de produto sonham em adicionar IA aos seus produtos. Mas eis a pergunta de um milhão de dólares: precisa mesmo de IA?
Compreendo que o termo “orientado por IA” fique bem numa apresentação para investidores e nos materiais de marketing de qualquer produto, mas não se esqueça de que criar um modelo de IA é dispendioso e moroso.
Assim, se o seu modelo de IA se destinar a resolver um problema básico que poderia ter tratado facilmente com código comum, acabará por desperdiçar os seus fundos num termo apelativo no seu site.
Para compreender se precisa de um modelo de IA, vejamos as tarefas e os problemas que pode resolver com ele e comparemo-los com aqueles que deve resolver através de programação convencional.
Have an account? Log In
Tarefas comuns que os modelos de aprendizagem automática podem tratar por si
Os modelos de ML não são mágicos — embora, com todas as formas de utilizar o ChatGPT e outros novos modelos de linguagem de grande dimensão, certamente pareça que sim. Embora estejamos a assistir a um aumento das ferramentas avançadas de IA, muitos produtos podem beneficiar de modelos de ML mais simples.
A função desempenhada por estes modelos enquadra-se normalmente numa destas quatro categorias.
Classificação
Como o nome sugere, estes modelos conseguem reconhecer a informação que lhes fornece e classificá-la ou atribuir-lhe um rótulo. O exemplo do reconhecimento de animais a partir da imagem que abordámos anteriormente é um caso típico de classificação por IA.
A área da classificação por IA divide-se, por sua vez, em quatro tipos:
Classificação binária: este modelo dar-lhe-á um Sim ou um Não. Os casos de utilização comuns incluem detetores de spam em e-mails (isSpam = true ou false), diagnóstico de cancro da mama (arriscado ou não arriscado), etc.
Classificação desequilibrada: estes modelos dividem os dados em dois grupos — maioria normal e minoria anormal. Um exemplo é a deteção de fraude nas declarações aduaneiras nas fronteiras dos estados.
O modelo de IA examinará os documentos e atribuirá indicadores verdes (tudo em ordem), amarelos (é necessária uma inspeção dos documentos) ou vermelhos (é necessária uma inspeção das mercadorias) a cada declaração aduaneira, dependendo do quão “normais” os documentos parecem em comparação com os outros.
Classificação multiclasse: Neste caso, o modelo selecionará um dos muitos valores predefinidos. Os algoritmos de reconhecimento ótico de caracteres (os que extraem texto de uma imagem) pertencem a este tipo.
Classificação multietiqueta: Ao contrário do caso anterior, estes modelos atribuem várias etiquetas à mesma informação. Muitos algoritmos de visão computacional enquadram-se nesta categoria, pois analisam a imagem ou o vídeo e identificam vários objetos nele. Eis o aspeto da classificação multietiqueta num carro autónomo.
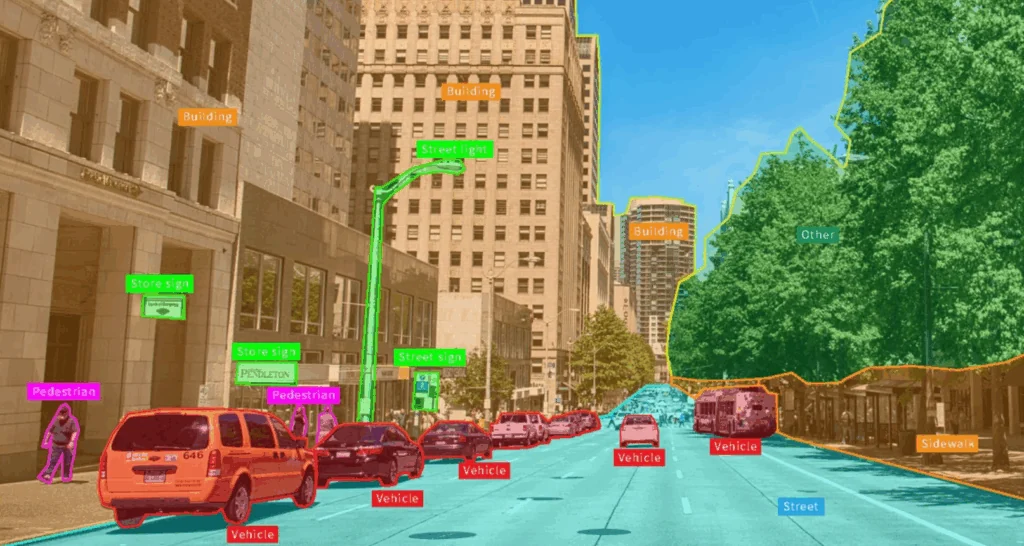
Outras aplicações desta tecnologia incluem extrair informações úteis do texto (por exemplo, opiniões sobre a sua marca a partir de Tweets) ou identificar os tópicos de discussão num podcast.
Regressão
Esta classe de modelos de IA é capaz de fazer previsões com base em informações existentes. Com os modelos de regressão, pode compreender a relação entre vários fatores, bem como prever valores futuros com base nos valores passados (ou seja, algoritmos de previsão).
Alguns dos usos dos algoritmos de regressão incluem:
- Prever o preço das ações com base na flutuação de preços anterior.
- Prever o preço de um carro com base na quilometragem, no ano de produção, etc.
- Sugerir os melhores textos para anúncios, de modo a obter melhores taxas de conversão.
- Encontrar o melhor dia da semana e a melhor hora para enviar e-mails, de modo a obter o maior número de aberturas e cliques.
Alguns dos modelos de maiores dimensões também são capazes de prever coisas tão complexas e caóticas como o tempo.
Agrupamento
Este é o processo baseado na aprendizagem não supervisionada em que o modelo deteta semelhanças num conjunto de itens e agrupa-os com base nessa semelhança. Ao contrário da classificação, um algoritmo de agrupamento não faz ideia do que está a analisar; apenas sabe que estes itens são semelhantes entre si.
Alguns dos casos de utilização dos algoritmos de agrupamento são:
- Agrupar a sua lista de marketing por e-mail em segmentos que se comportam de forma semelhante.
- Organizar um grande conjunto de livros por tópicos.
- Agrupar fotografias pelos itens nelas encontrados.
Em geral, se tiver um grande conjunto de itens que pretende dividir em diferentes grupos com base numa característica específica, precisará de algoritmos de agrupamento.
Síntese
Por fim, temos os algoritmos capazes de criar conteúdo. Estamos a falar de artistas, escritores e músicos de IA.
Os casos de utilização deste grupo de modelos são provavelmente intermináveis — e os modelos (agora designados por modelos de linguagem de grande dimensão, ou "LLMs") melhoram todos os dias. Eis alguns exemplos:
- Redatores para websites que criam estruturas e conteúdos otimizados para SEO.
- Remover a marca de água de uma imagem e desenhar a parte da imagem que estava por baixo da marca de água.
- Criar novos fotogramas num jogo em vez de deixar a placa gráfica renderizá-los, poupando recursos.
- Gerar fotografias para os seus anúncios que estejam isentas de licenças.
Eis um exemplo de um poema que pedi ao GPT-4 para escrever. (Nota: fiz a mesma pergunta ao GPT-3 em janeiro e garanto-lhe que hoje é muito mais talentoso.)
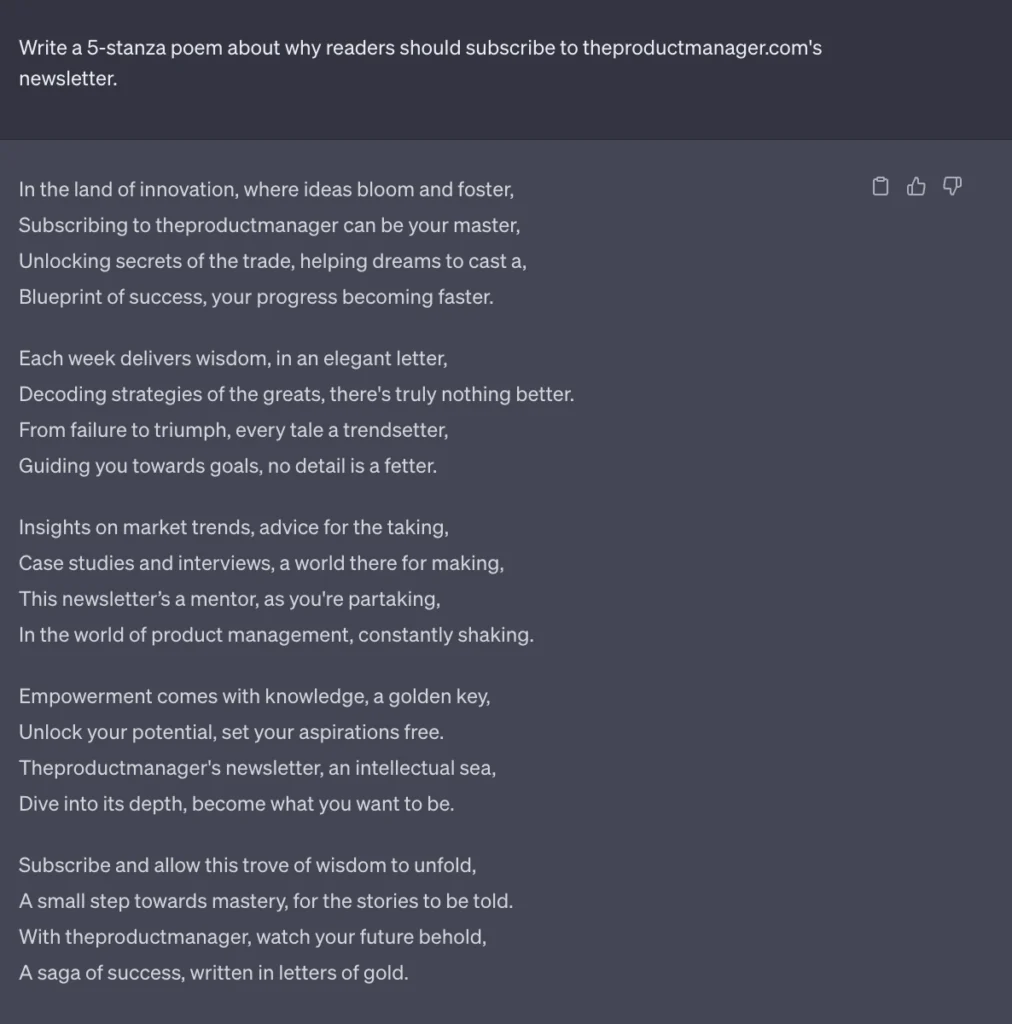
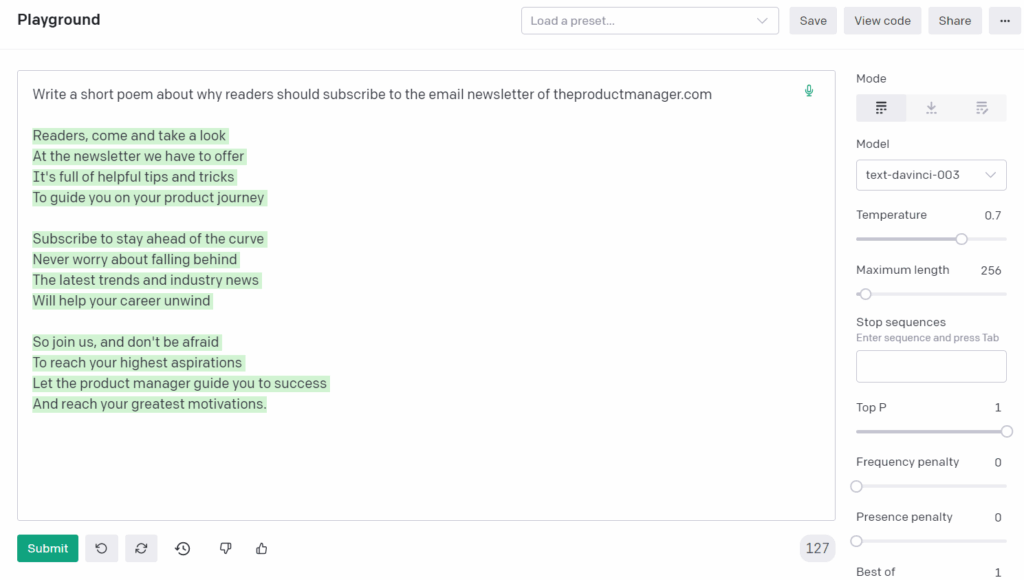
Pode utilizar linguagem natural para formular uma instrução, e o modelo compreenderá e cumprirá o seu pedido com base nos conhecimentos que reuniu na internet.
Em suma, estes são os tipos mais comuns de aplicações dos modelos de IA.
Parece que há muitas coisas que pode fazer com IA, mas, por vezes, é mais rápido e barato abandonar a ideia de criar um modelo e optar pelo simples desenvolvimento de um produto de software.
Tarefas em que deve utilizar programação convencional
Nem todos os problemas precisam de um modelo de IA para serem resolvidos.
Para determinar se consegue resolver o problema em questão sem IA, pergunte a si próprio se existe um conjunto determinístico e claro de regras ou ações que possa seguir para o resolver.
- Se a resposta for sim, então pode utilizar código convencional (afinal, o código é simplesmente um conjunto de regras e comandos claros para o seu computador). Por exemplo, não precisa de IA para determinar se o ficheiro carregado pelos seus utilizadores é uma folha de cálculo do Excel, uma vez que os ficheiros XLSX têm uma estrutura rigorosa que pode verificar.
- Quando não consegue identificar estas regras claras, terá de recorrer a modelos de IA para executar essa tarefa por si. O exemplo mais óbvio é o reconhecimento de imagens. Não existe um conjunto fiável de regras que lhe permita compreender se o objeto vermelho na imagem é um automóvel de uma determinada marca.
Para consolidar melhor este conceito, vejamos alguns problemas que pode resolver sem IA.
Encontrar o caminho mais curto entre o ponto A e o ponto B no mapa. Este é um problema bem conhecido da matemática e existem muitas abordagens determinísticas (por exemplo, o algoritmo de Dijkstra) que o podem resolver com código comum.
Verificar se existem engarrafamentos no mapa. Este problema tem uma solução inteligente. A Google, por exemplo, recolhe dados de localização GPS em tempo real de todos os smartphones (nos quais esta funcionalidade esteja ativada) e verifica se existem muitos telemóveis parados na estrada. Nesse caso, terá de existir um engarrafamento nesse local.
Nota: Embora possa utilizar IA neste caso para prever um engarrafamento numa estrada onde existam muito poucos smartphones ou onde as localizações estejam dispersas.
Calcular menções a uma marca nas redes sociais. Se quiser obter o número de menções à sua marca nas plataformas de redes sociais, tudo o que precisa é de uma ferramenta de recolha de dados que leia os resultados de pesquisa nas redes sociais e os contabilize.
Nota: Um modelo de IA seria útil neste caso para prever o número de menções com base na recolha de dados de uma pequena parte dos resultados (em vez de toda a lista de resultados da pesquisa), poupando capacidade computacional e recursos.
Em suma, os modelos de IA são bastante capazes no que diz respeito às tarefas que conseguem executar, mas, por vezes, é mais fácil programar.
Agora que já compreende como utilizar a Inteligência Artificial nos seus produtos, vou partilhar algumas sugestões sobre como trabalhar com modelos de IA.
6 sugestões para gestores de produto que trabalham com aprendizagem automática
Ao longo da minha carreira a trabalhar com produtos de aprendizagem automática, cometi muitos erros que resultaram numa perda de tempo e dinheiro. Para garantir que não repete estes erros, enquanto gestor de produto de ML, apresento algumas sugestões úteis a considerar.
A qualidade dos dados pode determinar o sucesso ou o fracasso dos seus modelos
As equipas de engenharia de ML e os cientistas de dados gostam de utilizar a expressão “entra lixo, sai lixo”. Isto significa que a qualidade do modelo dependerá diretamente da qualidade dos conjuntos de dados que utiliza para o treinar.
Para compreender o que quero dizer com dados de má qualidade, vejamos alguns dos aspetos que determinam a sua qualidade:
Anotações incorretas: A anotação é o processo de etiquetar manualmente novos dados para os utilizar como “resultados corretos” no treino do seu modelo. Por exemplo, os anotadores de um modelo que reconhece animais irão realçar o animal na imagem e identificá-lo com o respetivo nome. Se identificar elefantes como “pinguins”, o seu modelo fará o mesmo depois do treino.
Falta de diversidade: Os seus modelos só funcionarão bem se os dados do mundo real forem semelhantes aos dados com os quais foram treinados. Se tiver um sistema de deteção de matrículas que aprendeu a ler apenas matrículas dos EUA, falhará completamente quando detetar um automóvel com matrículas da UE.
Enviesamento dos dados: Já ouviu falar de IA racista? Bem, a Google pediu recentemente desculpa à comunidade afro-americana porque o seu algoritmo de visão computacional fez o seguinte:
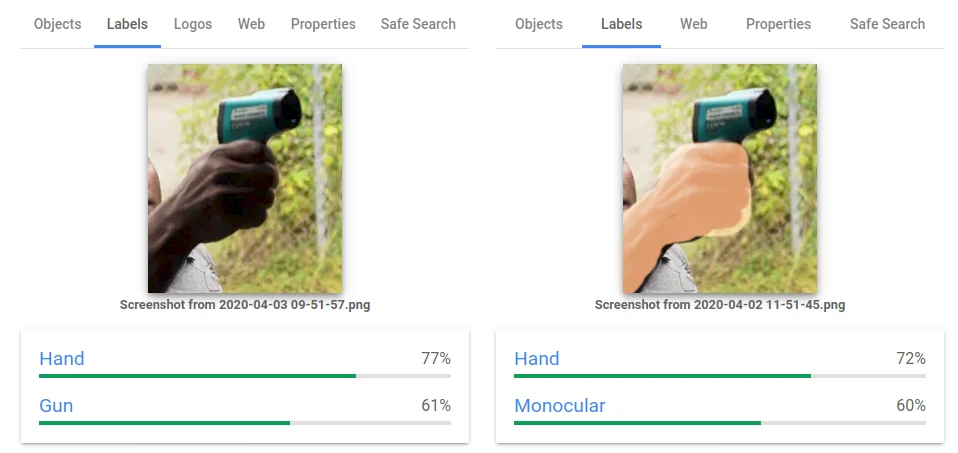
Existem também inúmeros casos de modelos de IA policiais que visam minorias.
A razão por detrás disto são os dados enviesados. Estas IAs policiais tinham utilizado a base de dados de uma esquadra conhecida pelo seu enviesamento racial. Consequentemente, existiam muitos dados sobre detenções de pessoas pertencentes a minorias, o que levou o modelo de IA a visar essas pessoas.
Por isso, certifique-se de que os dados que utiliza não contêm enviesamentos que possam potencialmente conduzir a desrespeito, ofensa ou algo pior.
Crie funcionalidades que o ajudem a treinar novamente os seus modelos
Criar modelos é apenas metade do trabalho — também precisa de os melhorar constantemente, adicionando novas capacidades ou simplesmente fornecendo-lhes dados recentes para um novo treino.
Encontrar dados relevantes para retreinar o seu produto de ML pode ser um desafio. Por isso, considere adicionar funcionalidades que lhe permitam obter esses dados diretamente do próprio produto.
Eis duas abordagens de ciclo de feedback que experimentei (e que funcionaram bem):
Pedir feedback sobre os resultados da IA: Se estiver a detetar spam no e-mail, adicione um botão “não é spam” para que os seus utilizadores possam remover o e-mail da pasta de spam. Como resultado desta ação, também irão “anotar” esse e-mail como livre de spam e poderá utilizá-lo para retreinar o seu modelo.
Nota: Sim, é exatamente isso que o botão “Denunciar como não sendo spam” faz no Gmail.
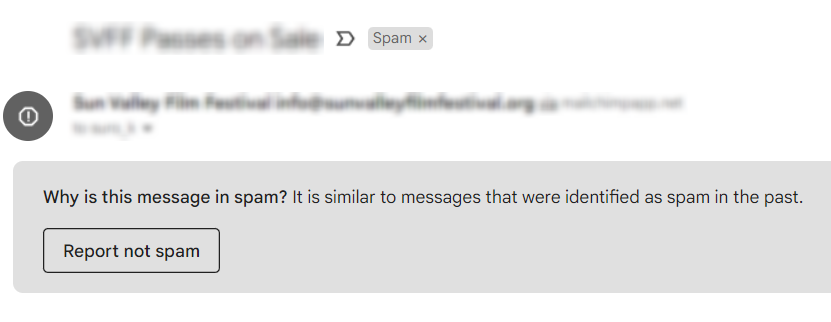
Permitir que o utilizador ajuste o seu modelo com base nos próprios dados: É uma situação vantajosa para ambas as partes. Os seus utilizadores obterão um modelo com melhor desempenho, porque o retreinou com base nos dados específicos deles, enquanto obterá dados adicionais para aumentar a diversidade do seu modelo.
Se puder, utilize soluções prontas em vez de criar as suas
Não precisa de reinventar a roda da IA. Existem muitos modelos prontos que pode comprar ou alugar. Isto é especialmente relevante se estiver a tentar resolver um problema relativamente comum (por exemplo, identificar imagens de nudez na sua aplicação de redes sociais).
Pode encontrar modelos prontos em plataformas como a Modelplace e o RapidAPI Hub.
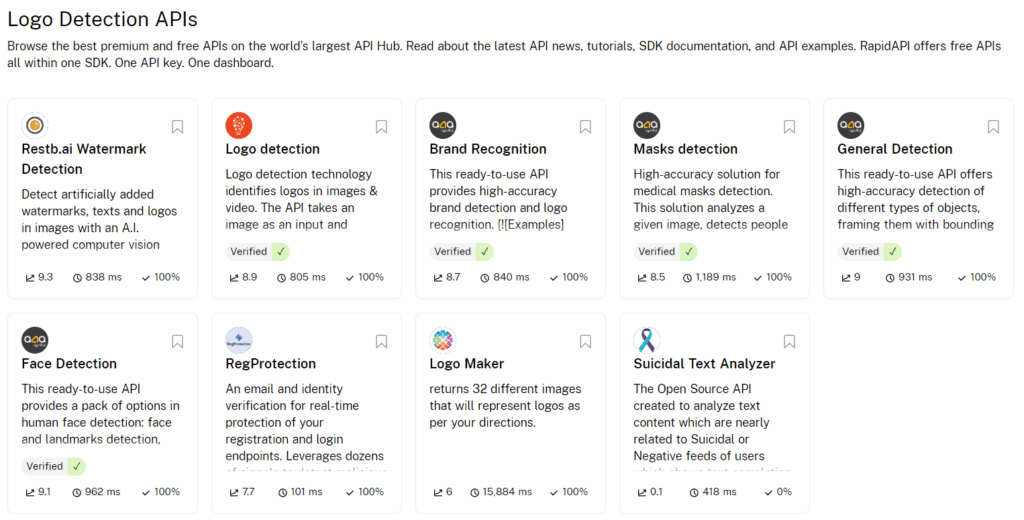
Uma simples pesquisa por um modelo de deteção de logótipos apresentou-nos 9 soluções prontas que podemos integrar através de uma API.
Utilize e contribua para modelos de IA de código aberto
A Inteligência Artificial tem uma comunidade significativa de código aberto. Pode recorrer a ela para encontrar modelos prontos ou ferramentas úteis que o ajudem a criar os seus modelos.
Pode consultar esta lista no GitHub de alguns dos melhores projetos e iniciativas de aprendizagem automática de código aberto disponíveis. Esta lista é bastante diversificada e inclui:
- Modelos com diferentes níveis de explicabilidade (o grau de facilidade com que pode explicar a forma como o seu modelo funciona), escritos em Python e C por gigantes como a IBM e a Amazon.
- Dados de treino para os seus modelos.
- Ferramentas para análise de dados, acompanhamento de métricas essenciais, deteção de anomalias e muito mais.
Nota: Se tiver feito melhorias a estes modelos, abra um pedido de incorporação e partilhe o seu trabalho com a comunidade de código aberto e as partes interessadas. O código aberto diz respeito a pessoas extraordinárias que fazem coisas extraordinárias e as partilham com os outros.
More Articles
- As 10 melhores ferramentas de gestão de produtos com IA analisadas em 2026
- Porque não deve deixar a IA escrever as suas histórias de utilizador
- Porque é que o roteiro de IA está ao contrário (e o que os líderes podem fazer quanto a isso)
- As 10 melhores ferramentas de IA para UX analisadas em 2026
- Bootcamp de Liderança: 12 Cursos de Liderança de Produto Que Vão Fazer-te Evoluir
A criação de modelos de IA demora tempo
As metodologias Agile e MVP nem sempre funcionam com sistemas de ML. Nem sempre é possível criar um modelo pequeno e depois adicionar-lhe novas funcionalidades através de várias iterações. Por vezes, alterar ligeiramente um modelo significa retreiná-lo de raiz.
Pode até deparar-se com uma situação em que otimizar o seu modelo em 10% implique eliminar o antigo e criar um novo algoritmo de aprendizagem automática.
Outro aspeto a considerar é a especificidade do trabalho dos profissionais de ciência de dados ou das equipas multifuncionais que os incluem.
Por vezes, não conseguirão indicar-lhe quando concluirão o trabalho, uma vez que passam a maior parte do tempo a inventar algo completamente novo e não fazem ideia de quanto tempo demorará o processo de desenvolvimento. (Um excelente exemplo disso é o calendário em constante alteração do lançamento do Gemini da Google.)
Evite alterações drásticas na estrutura da sua base de dados
Esta é uma realidade dolorosa com que me deparei algumas vezes.
Se estiver a utilizar os seus próprios dados para retreinar os seus modelos, evite alterar a estrutura da sua base de dados.
Os seus modelos serão criados para consumir dados com uma estrutura e um tipo específicos e, se a sua equipa de engenharia de dados alterar as suas bases de dados, a sua equipa de ML terá de alterar os seus modelos e até de os retreinar de raiz.
A aprendizagem é um processo contínuo.
A inteligência artificial tornou o mundo um lugar melhor para todos nós, pois permitiu que muitos fundadores visionários e gestores de produto de ML resolvessem problemas que, no passado, pareciam impossíveis.
Espero que este guia o tenha ajudado a compreender o conceito de IA na gestão de produtos, o papel do gestor de produto neste processo, bem como as formas como as empresas podem utilizar a IA no mundo real.
Mas criar novos produtos excelentes não se resume à utilização adequada da IA. Existem também muitos aspetos importantes do produto que deve dominar, incluindo:
- A arte de criar Produtos Mínimos Viáveis.
- Planear corretamente o trabalho da sua equipa com roteiros de produto.
- Encontrar o seu PMF de forma económica, entre outros aspetos.
Por fim, tal como o poema da demonstração do GPT-3 sugeriu, pode subscrever o nosso boletim informativo para obter o melhor da gestão de produtos e manter-se na vanguarda.