
Sztuczna inteligencja jest obecnie prawdopodobnie najgorętszym tematem w świecie technologii.
Produkty oparte na AI stają się jednorożcami lub pozyskują setki milionów dolarów finansowania venture capital. Istnieją również znani liderzy produktów, którzy kierują tymi produktami opartymi na AI, a my śledzimy ich działania i uczymy się od nich.
Wielu menedżerów produktu chce czerpać korzyści z tej niezwykłej technologii, kierując produktem opartym na AI lub dodając funkcje AI do swoich istniejących produktów. Jeśli należysz do tej grupy, ten tekst jest właśnie dla Ciebie.
Zbudowałem kilka produktów opartych na AI i jestem tutaj, aby pomóc Ci zrozumieć tę technologię oraz w pełni ją wykorzystać.
Czym jest uczenie maszynowe?
Uczenie maszynowe to dziedzina, która koncentruje się na tworzeniu algorytmów i oprogramowania zdolnych do „uczenia się” na podstawie dostarczanych przez nas informacji oraz skutecznego wykonywania określonych rodzajów zadań w wyniku tego treningu.
Sam termin i dziedzina są zaskakująco stare — ich początki sięgają 1959 roku, kiedy Arthur Samuel z IBM (jeden z czołowych informatyków tamtych czasów) użył tego określenia w swojej pracy „Niektóre badania nad uczeniem maszynowym z wykorzystaniem gry w warcaby.”
Mimo 60-letniej historii uczenie maszynowe zyskało popularność dopiero w ostatniej dekadzie dzięki ogromnemu wzrostowi mocy obliczeniowej, zwłaszcza procesorów graficznych.
Ale co uczenie maszynowe ma wspólnego ze sztuczną inteligencją? Wyjaśnijmy to, zanim przejdziemy dalej.
Uczenie maszynowe (ML) a sztuczna inteligencja (AI)
Wszyscy używają terminów „uczenie maszynowe” i „sztuczna inteligencja” zamiennie, odnosząc je do inteligentnego oprogramowania zdolnego do rozpoznawania obiektów na obrazach, pisania wierszy i generowania imponujących odpowiedzi na szczegółowe polecenia.
Sztuczna inteligencja jest jednak szerszym pojęciem obejmującym maszyny wyposażone w zdolności percepcji i rozumowania, podczas gdy uczenie maszynowe jest podzbiorem AI skupiającym się na oprogramowaniu, które potrafi się uczyć.
Skoro definicje terminów mamy już za sobą, przejdźmy do zrozumienia, w jaki sposób te maszyny się uczą, oraz do podstaw ich działania.
Jak działa uczenie maszynowe

Aby zrozumieć uczenie maszynowe, powinniśmy najpierw omówić jego najczęściej spotykaną formę — głębokie sieci neuronowe.
Sieć neuronowa to struktura zapisana w zwykłym kodzie, która próbuje odtworzyć działanie biologicznego mózgu. U ludzi i innych żywych organizmów mózg jest złożoną siecią neuronów (komórek nerwowych) połączonych ze sobą, w której impuls z jednej komórki aktywuje kolejną, a informacja przemieszcza się wzdłuż sieci neuronów.
Nie sądzę, abym był odpowiednią osobą do wyjaśniania biologii (ponieważ poniósłbym na tym sromotną porażkę), więc pozostanę przy technologii.
Sieci neuronowe w oprogramowaniu wyglądają mniej więcej tak:
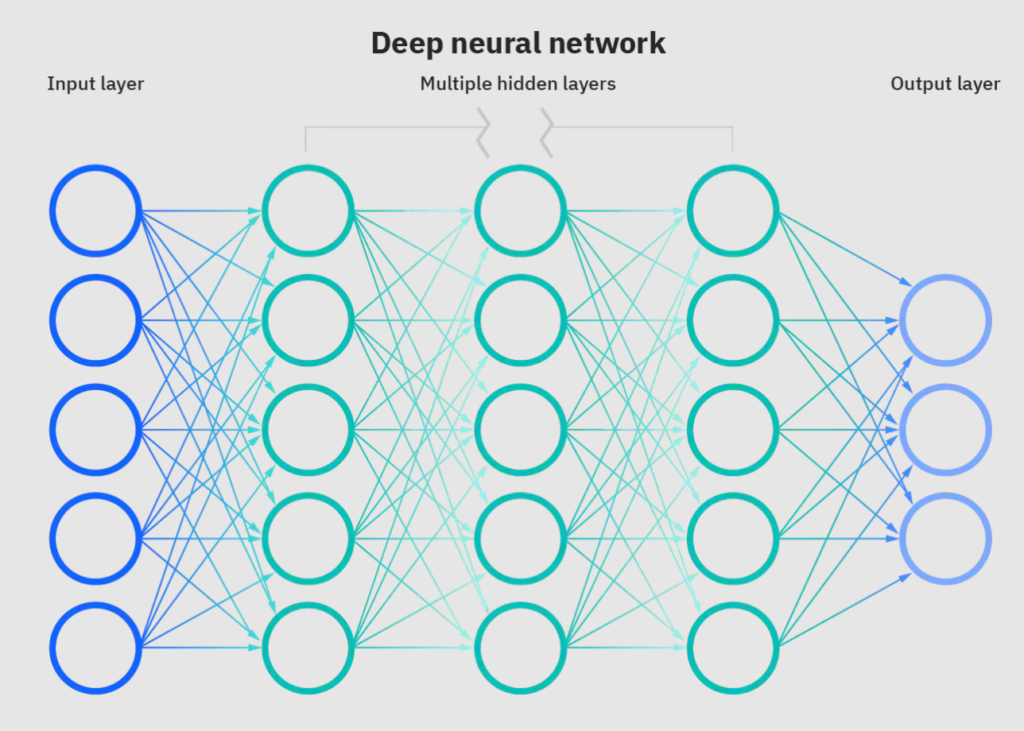
Każdy okrąg przedstawiony tutaj to pojedynczy neuron. W kodzie neuron jest po prostu funkcją, która może przyjąć pewien rodzaj informacji, przetworzyć ją i przekazać wynik do kolejnego neuronu.
Uwaga: jest to uproszczenie rzeczywistego procesu. Więcej szczegółów znajdziesz w wyjątkowej lekcji wideo o sieciach neuronowych na kanale YouTube 3blue1brown, gdzie wyjaśniono również koncepcje matematyczne stojące za tą technologią.
Jak widać na powyższym obrazie, nasze neurony są zorganizowane w warstwy. Sieci neuronowe mają zazwyczaj trzy rodzaje warstw:
- Warstwa wejściowa odpowiada za pobieranie informacji ze świata zewnętrznego.
- Warstwy ukryte przetwarzają te informacje, przy czym każda z nich przetwarza pojedynczy ich aspekt.
- Warstwa wyjściowa przekazuje przetworzony wynik z powrotem do świata zewnętrznego.
Teraz zrozummy znaczenie tych warstw na prostym przykładzie. Wyobraź sobie, że chcesz, aby sieć neuronowa rozpoznała zwierzę na zdjęciu. W tym celu zaprojektowałeś sieć neuronową składającą się z sześciu warstw, które będą działać w następujący sposób:
- Warstwa wejściowa, która pobierze małe fragmenty zdjęcia zwierzęcia i przekaże je do pierwszej warstwy ukrytej.
- Pierwsza warstwa ukryta spróbuje znaleźć podstawowe kształty (np. proste linie) w każdym fragmencie i przekaże te informacje do drugiej warstwy.
- Druga warstwa połączy następnie niektóre z tych linii w podstawowe formy geometryczne (np. okręgi, półokręgi itd.) i przekaże je do trzeciej warstwy.
- Trzecia warstwa utworzy następnie bardziej złożone kształty na podstawie tych form geometrycznych.
- Czwarta warstwa połączy wszystkie wcześniej utworzone kształty i uzyska zarys zwierzęcia.
- Warstwa wyjściowa ostatecznie wskaże rodzaj zwierzęcia rozpoznanego na podstawie kształtu.
Tak będzie to wyglądać w praktyce.
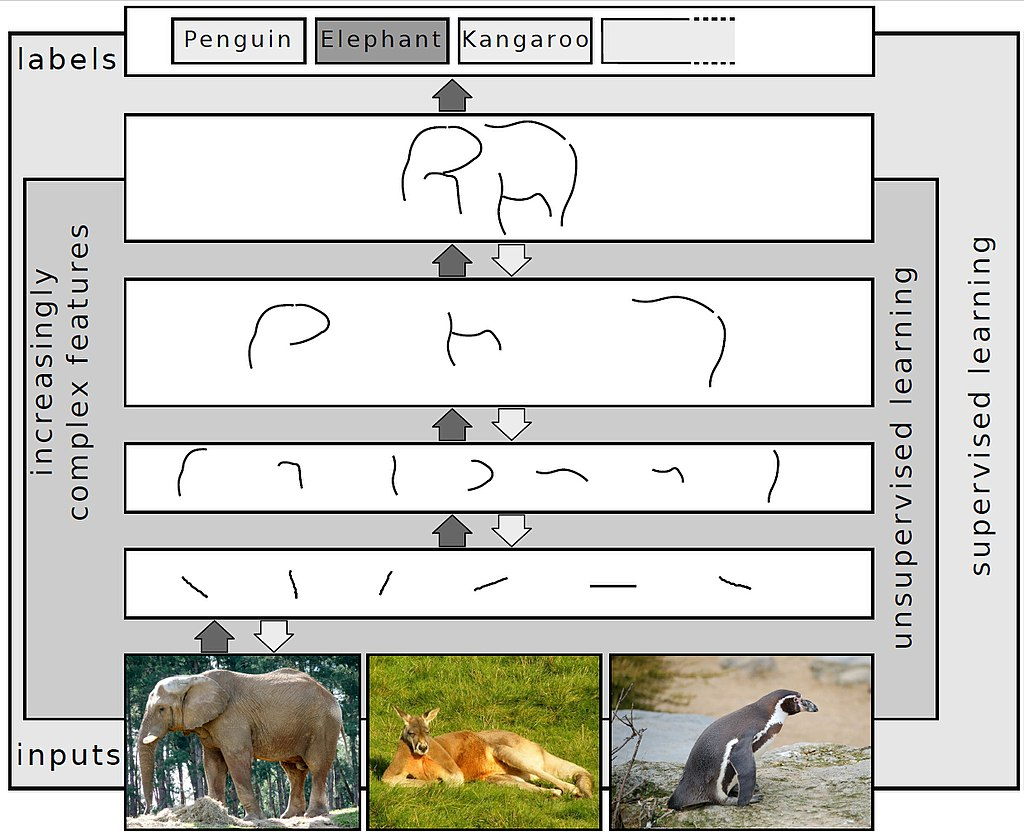
Patrząc na powyższy proces, możesz zastanawiać się, w jaki sposób inżynierowie AI sprawiają, że te warstwy rozpoznają kształty i odgadują zwierzę na obrazie, prawda? Robią to poprzez „trenowanie” sieci neuronowej, aby wykonywała swoje zadanie.
Aby wytrenować sieć, inżynierowie AI dostarczają jej zestaw danych wejściowych wraz z odpowiadającymi im prawidłowymi danymi wyjściowymi. W naszym przypadku byłoby to kilka zdjęć zwierząt jako danych wejściowych oraz te same zdjęcia z prawidłowym rodzajem zwierzęcia jako danymi wyjściowymi.
Ponieważ Twoja sieć zna prawidłowe odpowiedzi, będzie nieustannie dostosowywać się (parametry przekazywane przez każdy neuron do innych neuronów), aż jej odpowiedzi będą bardzo podobne do prawidłowych odpowiedzi, które jej dostarczyliśmy.
W rzeczywistości Twoja sieć nigdy nie będzie w 100% dokładna w swoich odpowiedziach i zawsze wystąpi pewien poziom błędu, który musisz uwzględnić. Dobrą wiadomością jest to, że tak naprawdę nie chcesz, aby odpowiedzi były w 100% poprawne. Zależy Ci jedynie na tym, aby model był szybszy i dokładniejszy niż człowiek.
Skoro rozumiemy już, jak to działa, przejdźmy do omówienia sposobów wykorzystania uczenia maszynowego w produktach.
Uczenie maszynowe: co może, a czego nie może

Entuzjazm wokół AI jest ogromny, a wielu założycieli startupów i menedżerów produktu marzy o dodaniu AI do swoich produktów. Ale oto pytanie za milion dolarów: czy naprawdę potrzebujesz AI?
Rozumiem, że określenie „oparty na AI” dobrze prezentuje się w prezentacji inwestycyjnej i materiałach marketingowych każdego produktu, ale nie zapominaj, że stworzenie modelu AI jest kosztowne i czasochłonne.
Jeśli więc Twój model AI ma rozwiązywać podstawowy problem, z którym z łatwością poradziłby sobie zwykły kod, ostatecznie zmarnujesz środki na efektowne określenie umieszczone na swojej stronie internetowej.
Aby zrozumieć, czy potrzebujesz modelu AI, omówmy zadania i problemy, z którymi możesz sobie poradzić przy jego użyciu, i porównajmy je z tymi, które powinieneś rozwiązać za pomocą standardowego programowania.
Have an account? Log In
Typowe zadania, z którymi mogą Ci pomóc modele uczenia maszynowego
Modele ML nie są magią — chociaż, biorąc pod uwagę wszystkie sposoby wykorzystania ChatGPT i innych nowych dużych modeli językowych, z pewnością może się tak wydawać. Obserwujemy wzrost liczby zaawansowanych narzędzi AI, ale wiele produktów może skorzystać z prostszych modeli ML.
Funkcje realizowane przez te modele zwykle należą do jednej z czterech kategorii.
Klasyfikacja
Jak sugeruje nazwa, modele te potrafią rozpoznawać dostarczane im informacje oraz klasyfikować je lub przypisywać im etykiety. Przykład rozpoznawania zwierząt na podstawie obrazu, który omówiliśmy wcześniej, jest typowym przypadkiem klasyfikacji AI.
Obszar klasyfikacji AI dzieli się z kolei na cztery typy:
Klasyfikacja binarna: ten model udzieli odpowiedzi Tak lub Nie. Typowe zastosowania obejmują filtry spamu w wiadomościach e-mail (isSpam = true lub false), diagnozowanie raka piersi (ryzykowne lub nieryzykowne) itd.
Klasyfikacja niezrównoważona: modele te dzielą dane na dwie grupy — normalną większość i nienormalną mniejszość. Przykładem jest wykrywanie oszustw w zgłoszeniach celnych na granicach państw.
Model AI przeanalizuje dokumenty i przypisze każdemu zgłoszeniu celnemu oznaczenie zielone (można zatwierdzić), żółte (wymaga sprawdzenia dokumentów) lub czerwone (wymaga kontroli towarów), zależnie od tego, jak „normalnie” wyglądają dokumenty w porównaniu z innymi.
Klasyfikacja wieloklasowa: W tym przypadku model wybierze jedną z wielu predefiniowanych wartości. Algorytmy optycznego rozpoznawania znaków (te, które wyodrębniają tekst z obrazu) należą do tego typu.
Klasyfikacja wieloetykietowa: W przeciwieństwie do poprzedniego typu modele te przypisują wiele etykiet do tego samego fragmentu danych. Wiele algorytmów widzenia komputerowego należy do tej kategorii, ponieważ analizują obraz lub nagranie wideo i identyfikują na nim wiele obiektów. Tak wygląda klasyfikacja wieloetykietowa w przypadku samochodu autonomicznego.
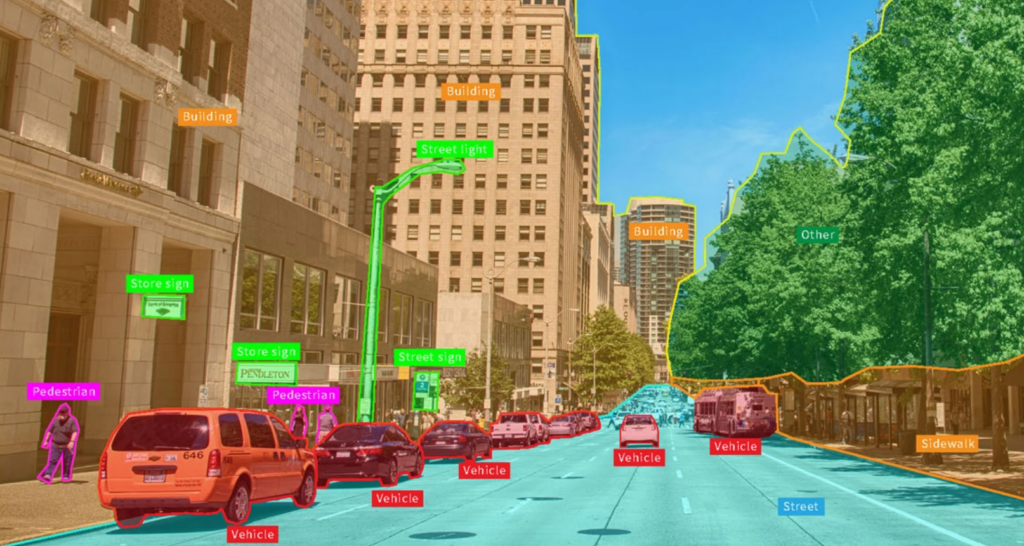
Inne zastosowania tej technologii obejmują wyodrębnianie przydatnych informacji z tekstu (np. opinii o Twojej marce z Tweetów) lub określanie tematów dyskusji w podcaście.
Regresja
Ta klasa modeli sztucznej inteligencji potrafi dokonywać prognoz na podstawie istniejących informacji. Dzięki modelom regresji można zrozumieć zależność między kilkoma czynnikami, a także przewidywać przyszłe wartości na podstawie tych z przeszłości (czyli za pomocą algorytmów prognozowania).
Niektóre zastosowania algorytmów regresji obejmują:
- Prognozowanie cen akcji na podstawie wcześniejszych wahań cen.
- Przewidywanie ceny samochodu na podstawie przebiegu, roku produkcji itp.
- Sugerowanie najlepszych treści reklam w celu zwiększenia współczynników konwersji.
- Znajdowanie najlepszego dnia tygodnia i czasu na wysyłkę e-maili, aby uzyskać jak najwięcej otwarć i kliknięć.
Niektóre większe modele potrafią również przewidywać rzeczy tak złożone i chaotyczne jak pogoda.
Grupowanie
Jest to proces oparty na uczeniu nienadzorowanym, w którym model wykrywa podobieństwa w zbiorze elementów i grupuje je według tych podobieństw. W przeciwieństwie do klasyfikacji algorytm grupowania nie wie, co widzi — wie jedynie, że te elementy są do siebie podobne.
Niektóre zastosowania algorytmów grupowania to:
- Dzielenie listy marketingowej e-maili na segmenty zachowujące się w podobny sposób.
- Porządkowanie dużego zbioru książek według tematów.
- Grupowanie zdjęć według znajdujących się na nich elementów.
Ogólnie rzecz biorąc, jeśli masz duży zbiór elementów, który chcesz podzielić na różne grupy na podstawie określonej cechy, potrzebujesz właśnie algorytmów grupowania.
Synteza
Na koniec mamy algorytmy zdolne do tworzenia treści. Mówimy tu o artystach, pisarzach i muzykach wykorzystujących sztuczną inteligencję.
Zastosowania tej grupy modeli są prawdopodobnie nieograniczone — a modele (obecnie określane jako duże modele językowe lub „LLM”) stają się coraz lepsze z każdym dniem. Oto niektóre z nich:
- Autorzy treści na strony internetowe, którzy tworzą strukturę i treści zoptymalizowane pod kątem SEO.
- Usuwanie znaku wodnego z obrazu i odtworzenie fragmentu obrazu, który znajdował się pod znakiem wodnym.
- Tworzenie nowych klatek w grze zamiast renderowania ich przez kartę graficzną, aby oszczędzać zasoby.
- Generowanie zdjęć do reklam, które są wolne od opłat licencyjnych.
Oto przykład wiersza, którego napisanie zleciłem GPT-4. (Uwaga: w styczniu zadałem to samo pytanie GPT-3 i zapewniam, że dziś jest on znacznie bardziej utalentowany.)
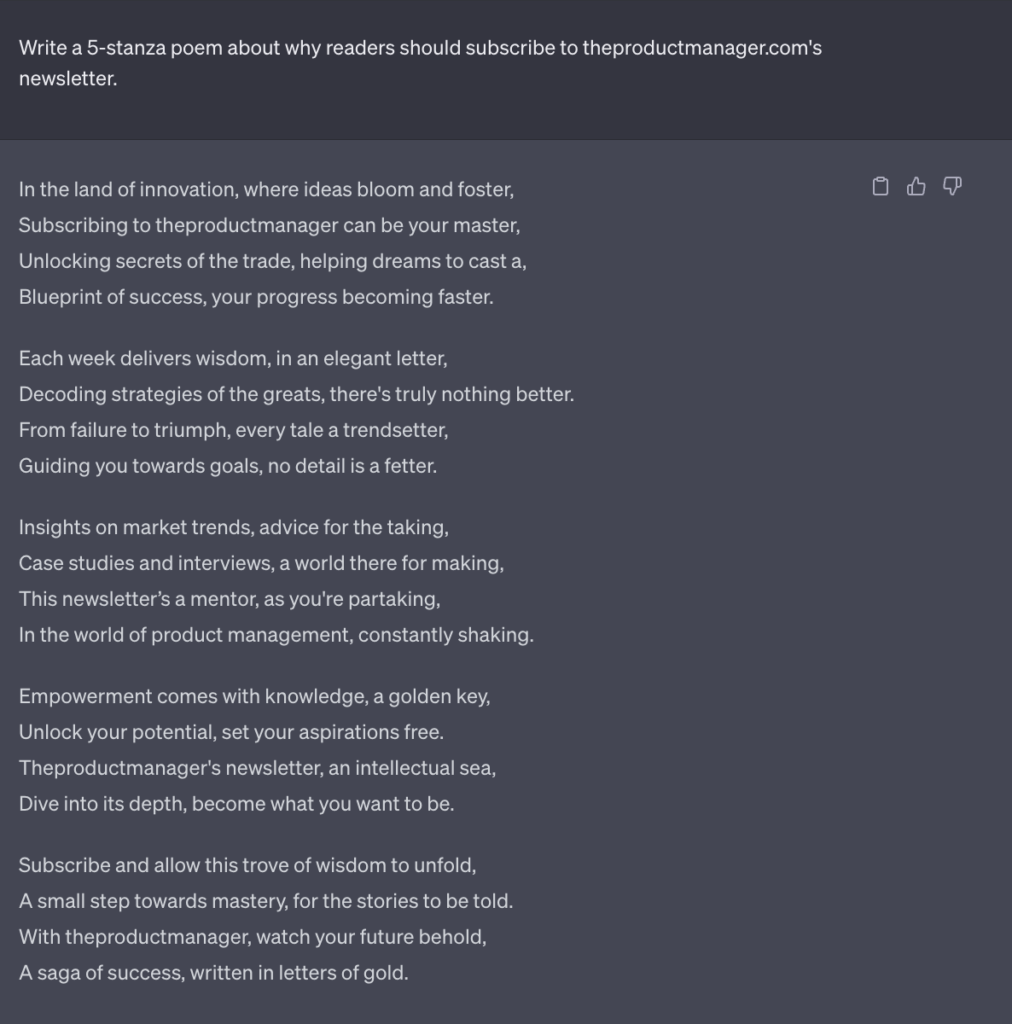
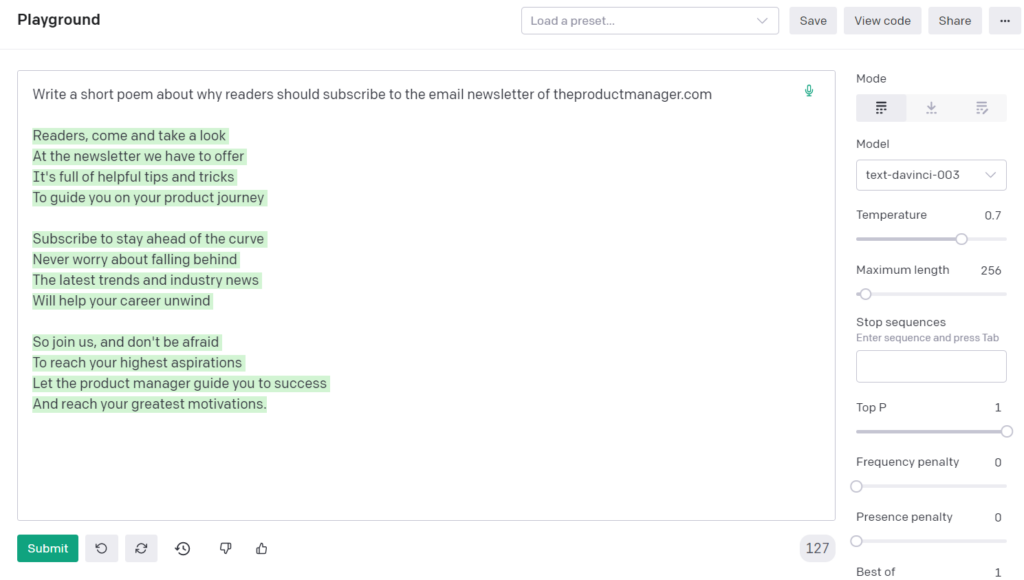
Możesz używać języka naturalnego do formułowania poleceń, a model zrozumie Twoją prośbę i spełni ją na podstawie wiedzy zgromadzonej z internetu.
Podsumowując, są to najczęstsze typy zastosowań modeli sztucznej inteligencji.
Wygląda na to, że dzięki sztucznej inteligencji można zrobić wiele rzeczy, ale czasami szybsze i tańsze jest porzucenie pomysłu budowania modelu i skorzystanie z prostego tworzenia oprogramowania.
Zadania, w których zamiast tego należy użyć zwykłego programowania
Nie każdy problem wymaga do rozwiązania modelu AI.
Aby ustalić, czy możesz rozwiązać dany problem bez użycia AI, zadaj sobie pytanie, czy istnieje deterministyczny i jasny zestaw reguł lub działań, które możesz podjąć, aby go rozwiązać.
- Jeśli odpowiedź brzmi „tak”, możesz użyć zwykłego kodu (w końcu kod jest po prostu zestawem jasnych reguł i poleceń dla komputera). Na przykład nie potrzebujesz AI, aby określić, czy plik przesłany przez użytkownika jest arkuszem kalkulacyjnym programu Excel, ponieważ pliki XLSX mają ściśle określoną strukturę i możesz to sprawdzić.
- Jeśli nie możesz wskazać tych jasnych reguł, będziesz musiał polegać na modelach AI, aby wykonały to zadanie za Ciebie. Oczywistym przykładem jest rozpoznawanie obrazów. Nie istnieje niezawodny zestaw reguł, który pozwoliłby Ci określić, czy czerwony obiekt na obrazie jest samochodem konkretnej marki.
Aby jeszcze lepiej wyjaśnić tę koncepcję, przyjrzyjmy się kilku problemom, które możesz rozwiązać bez AI.
Wyznaczanie najkrótszej trasy z punktu A do punktu B na mapie. Jest to dobrze znany problem matematyczny i istnieje wiele deterministycznych metod (np. algorytm Dijkstry), które mogą go rozwiązać za pomocą zwykłego kodu.
Sprawdzanie korków na mapie. To zadanie ma sprytne rozwiązanie. Google na przykład pobiera dane o lokalizacji GPS w czasie rzeczywistym ze wszystkich smartfonów (na których ta funkcja jest włączona) i sprawdza, czy na ulicy znajduje się wiele nieruchomych telefonów. Jeśli tak, musi tam być korek.
Uwaga: Możesz jednak użyć tutaj AI do przewidywania korków na ulicy, na której znajduje się bardzo niewiele smartfonów lub ich lokalizacje są rozproszone.
Obliczanie liczby wzmianek o marce w mediach społecznościowych. Jeśli chcesz poznać liczbę wzmianek o swojej marce na platformach społecznościowych, potrzebujesz jedynie narzędzia do skrobania danych, które odczyta wyniki wyszukiwania w mediach społecznościowych i je zliczy.
Uwaga: Model AI byłby tutaj przydatny do przewidywania liczby wzmianek na podstawie skrobania niewielkiej części wyników (zamiast całej listy wyników wyszukiwania), oszczędzając moc obliczeniową i zasoby.
Podsumowując, modele AI są całkiem skuteczne w realizacji zadań, ale czasami łatwiej jest po prostu napisać kod.
Skoro rozumiesz już, jak wykorzystywać sztuczną inteligencję w swoich produktach, przejdźmy do kilku wskazówek dotyczących pracy z modelami AI.
6 wskazówek dla menedżerów produktu pracujących z uczeniem maszynowym
W trakcie mojej kariery związanej z produktami wykorzystującymi uczenie maszynowe popełniłem wiele błędów, które doprowadziły do straty czasu i pieniędzy. Aby mieć pewność, że Ty, jako menedżer produktu ML, nie powtórzysz tych błędów, oto kilka przydatnych wskazówek, które warto wziąć pod uwagę.
Jakość danych zdecyduje o powodzeniu lub porażce Twoich modeli
Zespoły inżynierii ML i specjaliści ds. danych uwielbiają używać określenia „śmieci na wejściu – śmieci na wyjściu”. Oznacza ono, że jakość modelu będzie bezpośrednio zależeć od jakości zbiorów danych użytych do jego trenowania.
Aby wyjaśnić, co mam na myśli, mówiąc o złych danych, omówmy kilka aspektów, które decydują o ich jakości:
Błędne adnotacje: Adnotowanie to proces ręcznego oznaczania nowych danych, które mają służyć jako „poprawne wyniki” podczas trenowania modelu. Osoby adnotujące dane dla modelu rozpoznającego zwierzęta będą na przykład zaznaczać stworzenie na obrazie i oznaczać je jego nazwą. Jeśli oznaczysz słonie jako „pingwiny”, Twój model również będzie tak robił po treningu.
Brak różnorodności: Twoje modele będą działać dobrze tylko wtedy, gdy dane ze świata rzeczywistego będą podobne do danych, na których zostały wytrenowane. Jeśli masz system wykrywania tablic rejestracyjnych, który nauczył się odczytywać wyłącznie amerykańskie tablice, całkowicie zawiedzie, gdy zobaczy samochód z tablicami UE.
Stronniczość danych: Czy słyszałeś kiedyś o rasistowskiej AI? Google niedawno przeprosiło społeczność Afroamerykanów, ponieważ jego algorytm widzenia komputerowego zrobił coś takiego:
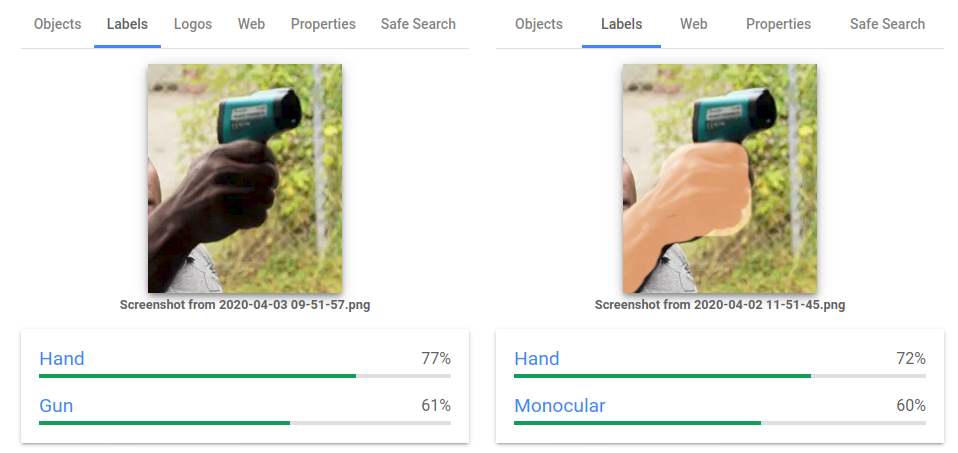
Istnieje również wiele przypadków, w których policyjne modele AI obierały za cel mniejszości.
Przyczyną są stronnicze dane. Te policyjne systemy AI korzystały z bazy danych komisariatu, który był znany z uprzedzeń rasowych. W rezultacie znajdowało się w niej wiele danych dotyczących aresztowań osób z mniejszości, co doprowadziło do obierania ich za cel przez model AI.
Dlatego upewnij się, że używane przez Ciebie dane nie zawierają uprzedzeń, które mogłyby potencjalnie prowadzić do braku szacunku, obrażania innych lub czegoś gorszego.
Twórz funkcje, które pomogą Ci ponownie trenować modele
Budowanie modeli to tylko połowa pracy — musisz również stale je ulepszać, dodając nowe możliwości lub po prostu dostarczając im świeże dane do ponownego treningu.
Znalezienie danych do ponownego trenowania, które byłyby istotne dla Twojego produktu ML, może być trudne. Rozważ więc dodanie funkcji, które umożliwią pozyskiwanie tych danych bezpośrednio z samego produktu.
Oto dwa podejścia do pętli informacji zwrotnej, które wypróbowałem (i które dobrze się sprawdziły):
Proszenie o opinię na temat wyników AI: Jeśli wykrywasz spam w wiadomościach e-mail, dodaj użytkownikom przycisk „to nie jest spam”, aby mogli usunąć wiadomość ze spamu. W wyniku tej czynności „oznaczą” oni również tę wiadomość jako wolną od spamu, a Ty będziesz mógł wykorzystać ją do ponownego trenowania modelu.
Uwaga: Tak, dokładnie to robi przycisk „Zgłoś brak spamu” w Gmailu.
Oferowanie użytkownikowi możliwości dostrojenia modelu na podstawie jego danych: To sytuacja korzystna dla obu stron. Użytkownicy otrzymają model działający lepiej, ponieważ ponownie go wytrenujesz na ich konkretnych danych, a Ty zyskasz dodatkowe dane zwiększające różnorodność modelu.
Jeśli możesz, korzystaj z gotowych rozwiązań zamiast tworzyć własne
Nie musisz wymyślać koła AI na nowo. Dostępnych jest wiele gotowych modeli, które możesz kupić lub wynająć. Jest to szczególnie istotne, jeśli próbujesz rozwiązać stosunkowo powszechny problem (np. identyfikowanie nagich zdjęć w aplikacji społecznościowej).
Gotowe modele znajdziesz na platformach takich jak Modelplace i RapidAPI Hub.
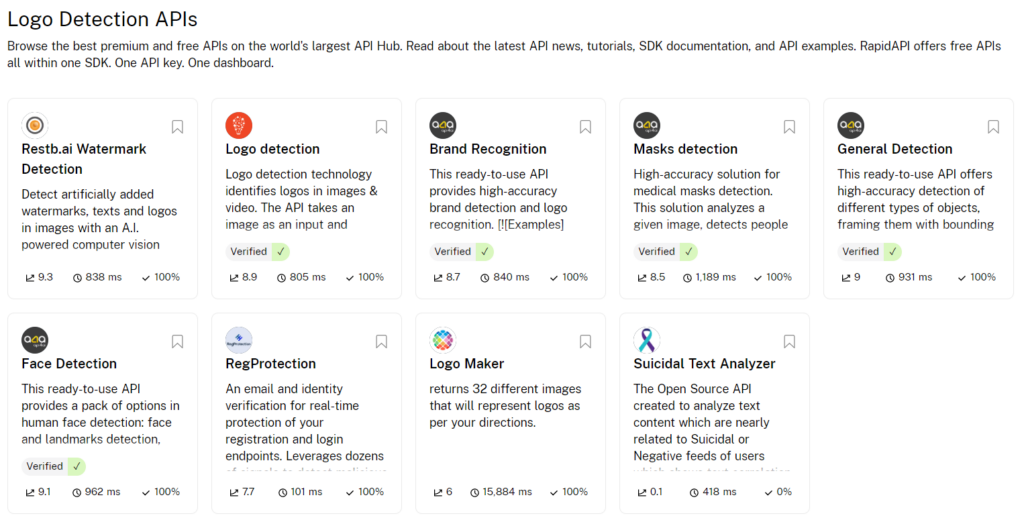
Proste wyszukanie modelu do wykrywania logo przyniosło nam 9 gotowych rozwiązań, które możemy zintegrować za pomocą API.
Korzystaj z modeli AI o otwartym kodzie źródłowym (i współtwórz je)
Sztuczna inteligencja ma dużą społeczność skupioną wokół otwartego kodu źródłowego. Możesz na niej polegać, aby znaleźć gotowe modele lub przydatne narzędzia pomocne w tworzeniu własnych modeli.
Na tej liście na GitHubie znajdziesz jedne z najlepszych dostępnych projektów i inicjatyw związanych z uczeniem maszynowym o otwartym kodzie źródłowym. Lista jest dość różnorodna i obejmuje:
- Modele o różnym poziomie wyjaśnialności (czyli tego, jak dobrze można wyjaśnić sposób działania modelu), napisane w językach Python i C przez gigantów takich jak IBM i Amazon.
- Dane treningowe do modeli.
- Narzędzia do analizy danych, śledzenia kluczowych wskaźników, wykrywania anomalii i nie tylko.
Uwaga: Jeśli wprowadziłeś jakiekolwiek ulepszenia w tych modelach, wyślij prośbę o scalenie i podziel się swoją pracą ze społecznością otwartego kodu źródłowego oraz jej interesariuszami. Otwarty kod źródłowy to wspaniali ludzie robiący wspaniałe rzeczy i dzielący się nimi z innymi.
More Articles
Tworzenie modeli AI wymaga czasu
Metodyki Agile i MVP nie zawsze sprawdzają się w przypadku systemów ML. Nie zawsze możesz zbudować mały model, a następnie dodawać do niego nowe funkcje w wielu iteracjach. Czasami niewielka zmiana modelu będzie oznaczać konieczność ponownego trenowania go od podstaw.
Możesz nawet spotkać się z sytuacją, w której optymalizacja modelu o 10% będzie oznaczać odrzucenie starego modelu i stworzenie nowego algorytmu uczenia maszynowego.
Kolejną kwestią, którą należy wziąć pod uwagę, jest specyfika pracy specjalistów ds. analizy danych lub zespołów interdyscyplinarnych, w których skład wchodzą takie osoby.
Czasami nie będą oni w stanie podać Ci terminu zakończenia pracy, ponieważ większość czasu poświęcają na wymyślanie czegoś zupełnie nowego i nie mają pojęcia, ile czasu zajmie im proces tworzenia. (Świetnym przykładem jest zmieniający się harmonogram premiery Gemini firmy Google).
Unikaj drastycznych zmian w strukturze bazy danych
To bolesna rzeczywistość, z którą zetknąłem się kilka razy.
Jeśli wykorzystujesz własne dane do ponownego trenowania modeli, powstrzymaj się od zmieniania struktury bazy danych.
Twoje modele będą tworzone tak, aby przetwarzać dane o określonej strukturze i określonym rodzaju, a jeśli zespół zajmujący się inżynierią danych zmieni Twoje bazy danych, zespół ML będzie musiał zmienić modele, a nawet ponownie wytrenować je od podstaw.
Nauka jest ciągłym procesem.
Sztuczna inteligencja uczyniła świat lepszym miejscem dla nas wszystkich, ponieważ pozwoliła wielu wizjonerskim założycielom i menedżerom produktów ML rozwiązywać problemy, które w przeszłości wydawały się niemożliwe do rozwiązania.
Mam nadzieję, że ten przewodnik pomógł Ci zrozumieć koncepcję sztucznej inteligencji w zarządzaniu produktem, rolę menedżera produktu w tym procesie, a także rzeczywiste sposoby wykorzystywania sztucznej inteligencji przez firmy.
Jednak tworzenie świetnych nowych produktów nie polega wyłącznie na właściwym wykorzystaniu sztucznej inteligencji. Istnieje również wiele ważnych aspektów związanych z produktem, które warto opanować, w tym:
- Sztuka tworzenia produktów o minimalnej niezbędnej funkcjonalności.
- Właściwe planowanie pracy zespołu za pomocą map rozwoju produktu.
- Znalezienie dopasowania produktu do rynku (PMF) w opłacalny sposób itd.
Na koniec, jak sugeruje wiersz z demonstracji GPT-3, możesz zapisać się do naszego biuletynu, aby otrzymywać najlepsze informacje na temat zarządzania produktem i wyprzedzać konkurencję.