
Er det ikke irriterende å spole gjennom timevis med dusinvis av intervjuopptak for å finne ett enkelt sitat som kan hjelpe deg med å ta en velbegrunnet produktbeslutning? Jeg hater det! Det sløser bort den verdifulle tiden du kunne ha brukt på å bygge fantastiske produkter.
Ofte er det nettopp slike kjedelige situasjoner som får oss til å innse at vi må holde intervjudataene våre organisert. Og for å gjøre dette må vi etablere en prosess for kontinuerlig å konkretisere denne læringen, og dermed omdanne den til funksjoner og løsninger.
Hvis dette høres kjent ut, men du ikke er sikker på hvordan du skal begynne å organisere de store mengdene med brukerundersøkelser, er det ingen grunn til bekymring. Jeg er her for å hjelpe!
Kraften i kvalitative intervjuer
Etter min mening er brukerintervjuer (og kvalitativ analyse generelt) den mest verdifulle typen arbeid produktledere utfører.
Du kan ikke lage fantastiske produkter uten å vite hvem brukerne dine er og hva de ønsker. Ved hjelp av intervjuer kan du derimot fordype deg i virkeligheten disse menneskene lever i og oppleve problemene og ulempene de møter i hverdagen når de utfører bestemte oppgaver.
Denne innsikten gir deg det riktige kunnskapsgrunnlaget for å utforme løsninger som faktisk er nyttige for dem, og som kan gjøre livene deres bedre. Derfor er det svært viktig for produktledere å optimalisere brukerintervjuprosessene sine og sørge for at de får mest mulig ut av den begrensede tiden de snakker med brukerne sine.
Slik organiserer du intervjudata
Det øyeblikket teamet ditt har gjennomført mer enn 20 brukerintervjuer, begynner ting å bli rotete. For å finne et bestemt sitat eller en bestemt innsikt må du kanskje finne personen som gjennomførte intervjuet og spørre dem om det. Uunngåelig vil de ikke huske de nøyaktige detaljene fra intervjuet.
Til slutt sitter du igjen med en mengde innsikter som ikke er knyttet til noen konkrete antakelser. Et slikt rot gjør det nesten umulig å hente ut nyttige lærdommer fra undersøkelsen.
Derfor er det så verdifullt å organisere brukerintervjuene dine grundig.
Grunnleggende organisering
Før vi går inn på de mer detaljerte prosessene, skal vi først se på de enkle måtene du kan holde intervjuene dine organisert på.
Navnekonvensjoner for intervjuer
Hvis du gjennomfører intervjuer hele tiden, vil du på et tidspunkt ende opp med hundrevis av opptak i skylagringskontoen din (eller i et idéverktøy). Bare forestill deg hvor smertefullt det ville være å søke gjennom store mengder av disse filene hvis navnene deres ser omtrent slik ut («ros» til Zoom for den forferdelige navngivningslogikken):
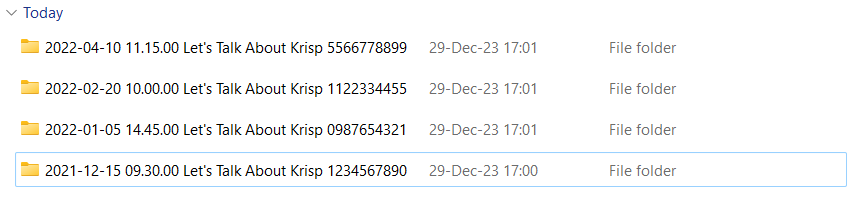
Det er umulig å finne et bestemt intervju her.
Vurder derfor å ta i bruk en standardisert navnekonvensjon som gjør intervjufilene søkbare. Kanskje noe som dette:
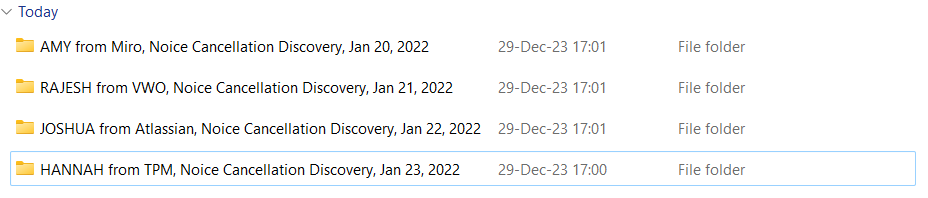
Nå har du strukturerte intervjuer med søkbare navn, emner og datoer. Du kan også legge til navnet på produktlederen som gjennomførte intervjuet. Men hvis du bruker et spesialisert intervjuprogram, vil både navnet og intervjudatoen allerede være søkbare, og du kan fjerne dem fra filnavnene.
Have an account? Log In
Planleggingsverktøy
Det kan også være tidkrevende å planlegge dato og tidspunkt for intervjuet. Det blir lange e-postutvekslinger med respondentene dine mens dere prøver å finne riktig tidspunkt og dag for samtalen. Det blir også ekstra bryderi når noen ikke møter opp, og du må planlegge møtet på nytt.
Med et planleggingsverktøy kan du derimot enkelt angi tilgjengelige tidsluker for samtalene dine og la intervjudeltakerne velge den som passer best for dem.
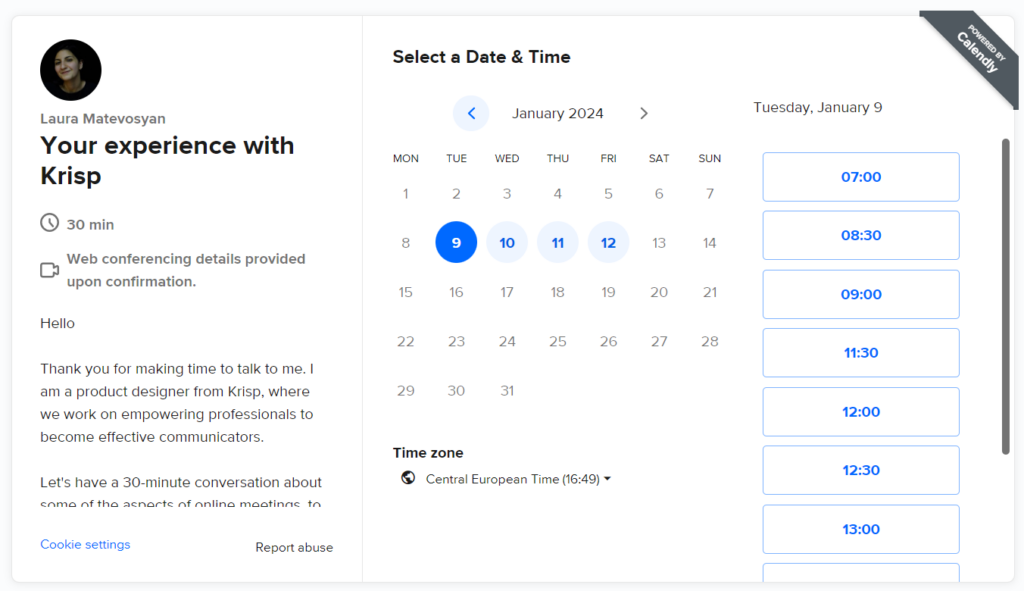
Du kan bruke hvilket som helst planleggingsverktøy til dette formålet, blant annet Calendly, Google Workspace og Hubspot.
Delte kalendere
Dette er spesielt nyttig når flere personer i teamet ditt gjennomfører intervjuer. Med en delt kalender kan du «overlate» intervjuet som er planlagt for deg til en kollega dersom du ikke kan delta.
Du kan dessuten dele denne kalenderen med hele selskapet og oppmuntre folk fra ulike avdelinger til å delta og høre hva brukerne sier om produktet ditt. Denne taktikken er en flott måte å holde alle «brukerbevisste» på og bryte ned siloer mellom avdelingene.
Transkribering og oppsummering
Produktteam gjør tradisjonelt et lyd- og videoopptak av intervjuene sine. Deretter bruker vi disse opptakene til å analysere innsiktene og finne konkrete sitater som vi ønsker å fremheve i funnene våre.
Det finnes også et bruksområde for dokumentasjon. Noen ganger ønsker du å gå tilbake til gamle intervjuer og se på brukerens svar fra et annet perspektiv.
Problemet med lyd- og videoopptak er imidlertid at de tar lang tid å gjennomgå og er vanskelige å navigere i.
Derfor anbefaler jeg at du bruker et transkripsjons- og oppsummeringsverktøy (du kan også bruke KI i brukerundersøkelser for å få hjelp med dette).

Transkripsjoner er tekst du kan rulle gjennom og søke i. Hvis det er en bestemt del av et intervju du vil finne, trykker du bare på Command-F og søker etter den. I tillegg til å søke i det enkelte intervjuet lar mange verktøy deg også kjøre søk på tvers av alle intervjuene du har gjennomført.
Oppsummeringer er neste steg i utviklingen. Du kan be KI-LLM-modellen (som vanligvis er integrert i transkripsjonsverktøyet) om å lage en oppsummering av de viktigste funnene for deg.
På denne måten sparer du også mye tid på analysen av transkripsjonene dine. Med riktig kontekst er moderne LLM-er (spesielt GPT-4) ganske gode til å analysere intervjuet for deg.
Når det gjelder verktøy, bruker jeg Krisp nå fordi jeg leder produktet for transkripsjon og oppsummering der. Men jeg anbefaler også at du prøver Dovetail, Otter.ai, Fireflies.ai og andre. Alternativt kan du vurdere mer vitenskapelig og grundig programvare for kvalitativ dataanalyse, som Atlas.ti, Nvivo, Maxqda og andre.
Gruppere innholdet i intervjutranskripsjoner etter hypoteser
Mange verktøy for intervjuhåndtering lar deg fremheve bestemte deler av transkripsjonen og merke dem. Denne fantastiske funksjonaliteten lar deg organisere kundeintervjuene dine (samt casestudier, notater og andre forskningsprosjekter) basert på:
- Det overordnede temaet (f.eks. utforsking av inntektsmodeller, aktiveringsfunksjoner osv.)
- Personegenskaper (f.eks. geografi, yrke osv.)
- Brukertype når det gjelder engasjement (f.eks. inaktive brukere, superbrukere osv.)
Men den klart mest verdifulle anvendelsen av denne funksjonaliteten er sannsynligvis å fremheve brukersvar og merke dem basert på hypotesen de kan validere.
Det du vanligvis gjør, er å overføre alle de aktive hypotesene dine til intervjueverktøyet i form av merker og begynne å merke de relevante delene av intervjuene. Når du klikker på et av disse merkene, ser du en samling av alle relevante sitater fra alle intervjuene dine.
Slik ser det ut i Dovetail:
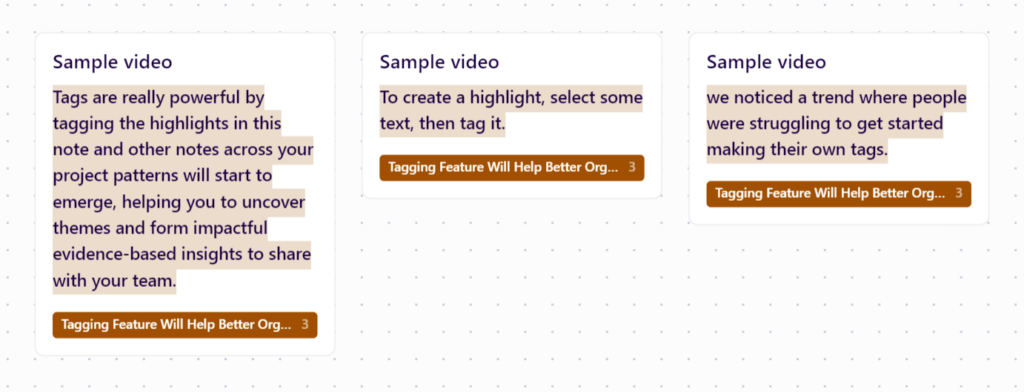
Som du ser, er det ganske praktisk – du kan få et overblikk over alt som er knyttet til hypotesen, på én enkelt skjerm, og ta en rask beslutning basert på det.
Nå som vi vet hvordan du organiserer brukerintervjudataene dine, går vi videre til hvordan du kan analysere dem.
Slik tolker du brukerintervjuer
Jeg pleier å la være å snakke om teori, men dette er et av de sjeldne tilfellene der det er verdifullt å lære den vitenskapelig-teoretiske tilnærmingen (og anvende den i virkelige situasjoner). Så la oss gå gjennom de tre klassiske metodene for kvalitativ dataanalyse. Tenk over hvordan du kan bruke KI i dataanalyse sammen med disse metodene.
Narrativ analyse
Denne typen analyse er den minst strukturerte og mest kvalitative metoden i gruppen. Den fokuserer utelukkende på brukernes historier og forsøker å avdekke interessante innsikter basert på hvordan de føler det når det gjelder produktet ditt, og hvordan de oppfatter det.
I motsetning til andre typer analyser er det brukernes følelser og måten de ser produktet ditt på i hverdagen, som betyr noe.
La oss bruke Slack som eksempel.
Forestill deg at du var en av de opprinnelige produktlederne i Slack og ønsket å revolusjonere måten folk kommuniserer på jobb. Du vet at folk hovedsakelig bruker e-post som sin primære kanal, og du ønsker å gi dem noe som ligner mer på sosiale medieplattformer (dvs. innlegg med kommentarer).
Når du gjennomfører en narrativ analyse, kan du be folk beskrive den daglige kommunikasjonen sin via e-post, lytte til klagene deres og få en helhetlig forståelse av hvordan folk føler det rundt denne delen av hverdagen.
Deretter ville du stilt de samme forskningsspørsmålene om erfaringen deres med innleggsformater fra sosiale medier, observert den følelsesmessige reaksjonen deres og forstått den typiske brukerreisen for å opprette innlegg og kommentere på dem.
Ved å bruke all denne innsikten (og anvende deduktiv resonnering) kan du deretter opprette brukerpersonaen din med deres mål og utfordringer. I tillegg vil du kunne visualisere de ulike brukerreisene og vanene du må ta hensyn til når du utvikler produktet ditt.
Tematisk analyse
I motsetning til narrativ analyse er denne metoden litt mer «kvantitativ» og lar deg tilføre litt struktur til innsikten din. Tematisk analyse handler om å lese gjennom intervjutranskripsjonene dine og identifisere ulike temaer som går igjen på tvers av flere intervjuer.
Tilbake til Slack-eksempelet ...
Når du analyserer svarene fra intervjudeltakerne dine, vil du kanskje snart oppdage at mange av dem klager over ulempen ved å administrere «visningstillatelser» (hvem som kan se meldingen din og hvem som ikke kan det) i en typisk lang e-postutveksling.
Flott, nå har du identifisert et felles tema (og et mulig unikt verdiforslag for funksjonen «kanaltillatelser»).
Du vil kanskje også identifisere en annen vanlig klage – ulempen ved å lese tidligere meldinger i en e-postutveksling. Der har du det! Nok et felles tema og en ny mulighet til å skille deg ut med den neste funksjonen din.
Taggefunksjonen jeg nevnte for et øyeblikk siden, er et flott verktøy for å gjennomføre tematisk analyse. Når du ser noe interessant i intervjutranskripsjonen, kan du fremheve det og legge til en «tema»-tagg. Deretter kan du åpne siden for «tema»-taggen og se alle sitatene som er knyttet til den.
Innholdsanalyse
Innholdsanalyse av intervjuer er den mest strukturerte og kvantitative forskningsmetoden av disse tre. I dette tilfellet er målet ditt å gjøre innsikten din målbar.
For eksempel ...
Hvis du allerede har identifisert et tema (for eksempel ulempen ved å administrere tillatelser i en e-postutveksling) i intervjuene dine, kan du forsøke å beregne prosentandelen av personer som synes dette er svært upraktisk, og sammenligne den med prosentandelen av personer som ikke er særlig plaget av det.
Ved å kvantifisere dataene dine vil du kunne forstå betydningen av funnene dine. Hvis bare 20 % av intervjudeltakerne synes at visningstillatelser i e-postutvekslinger er plagsomme, vil verdiforslaget for funksjonen din for kanaltillatelser være svakt.
Dette er selvfølgelig ganske nyttig. Men etter min erfaring er den mest verdifulle anvendelsen av innholdsanalyse å validere (eller avkrefte) hypotesene dine.
Med innholdsanalyse bruker du den samme teknikken som ved tematisk analyse. Men i dette tilfellet måler du prosentandelen av svarene som bekrefter hypotesen din. Tenk deg at du utvikler en app for transkripsjon (akkurat som Dovetail) med følgende hypotese:
Jeg tror at en reduksjon av behandlingstiden for transkripsjoner fra 10 minutter til 10 sekunder vil øke visningsfrekvensen for transkripsjoner betydelig
Tenk deg nå at du analyserer intervjusvarene dine og oppdager at 80 % av personene sier at de har intervjuer rett etter hverandre, og at de vanligvis leser transkripsjonene på slutten av arbeidsdagen.
Dette betyr at hypotesen din er ugyldig, og at du ikke bør kaste bort tid og ressurser på å optimalisere behandlingsmotoren din.
Bonusmetode for analyse: Forankret teori
Den tradisjonelle vitenskapelige metoden (som brukes mye innen produktledelse) starter med å formulere hypoteser og deretter validere dem med empiriske bevis.
Problemet er imidlertid at du ikke alltid kan formulere disse hypotesene. Noen ganger, særlig når du er i den tidlige idéfasen av oppstartsselskapet ditt, vet du ingenting om markedet og brukerne dine. Derfor finnes det ingen måte du kan skrive ned meningsfulle hypoteser på.
Det er her forankret teori kommer inn og hjelper deg.
I stedet for å lage hypoteser og deretter validere dem med data, leder forskningsprosessen deg her til å analysere data først og deretter lage hypoteser basert på innsikten du har funnet i dataene dine.
For et tidlig oppstartsselskap vil dette bety å begynne å intervjue brukere uten hypoteser og forstå behovene og brukerreisene deres. Først når du har en grunnleggende forståelse av hva de ønsker, kan du begynne å formulere hypotesene dine.
Slik følger du opp den kvalitative forskningen din
Brukerintervjuene dine er meningsløse (og beslutningene dine er fulle av forskningsskjevhet) hvis du ikke klarer å få noe handlingsrettet ut av dem. I denne delen går vi gjennom de grunnleggende stegene for å følge opp det du har lært, og ser på hvordan du kan anvende det i virkeligheten. Du kan også bruke KI i UX-forskning sammen med disse stegene.
Steg 1: Valider eller avkreft hypotesene dine
Med mindre du bruker forankret teori, bør hvert eneste brukerintervju ha som mål å validere én eller flere hypoteser. Slik validerer du hypotesene dine:
- Bruk funksjonene for tagging og annotering i intervjuverktøyet ditt til å samle all nødvendig innsikt knyttet til denne hypotesen på én enkelt skjerm.
- Inviter produktteamet ditt (inkludert UX-designere og interessenter), og vurder disse funnene.
- Bestem om du anser hypotesen som validert eller ikke.
Noen ganger er datasettet du har, kanskje ikke tilstrekkelig til å gi et entydig svar på spørsmålet ditt. I så fall gjennomfører du ganske enkelt flere intervjuer til du har samlet inn nok data.
Steg 2: Handle på grunnlag av avkreftede hypoteser
Hvis intervjufunnene dine avkrefter en hypotese (noe som er vanligere enn å validere en), kan du handle på grunnlag av den på to mulige måter:
- Revider hypotesen din: Kanskje deler av hypotesen var gyldig, og du trenger bare å lage en ny, modifisert hypotese basert på den gamle.
La oss for eksempel si at du har antatt at folk ville foretrekke å administrere tillatelsene for hvert enkelt innlegg i Slack. Intervjudataene viser at folk faktisk ønsker tillatelser, men at de ikke bør være knyttet til innleggsnivået. I dette tilfellet endrer du hypotesen til følgende:
Vi tror at folk vil foretrekke å administrere tillatelser på kanalnivå
- Se på den som avkreftet og forkast den: Hvis du ikke ser noen gjennomførbare revisjoner av hypotesen din, kan du ganske enkelt forkaste den og begynne å formulere nye hypoteser.
More Articles
Steg 3: Gjør validerte hypoteser om til produktløsninger
Hvis du ender opp med å validere hypotesen din, kan du begynne å arbeide med en produktløsning for den.
Jeg vet at det er åpenbart, men de fleste av oss ender opp med å utsette dette og til slutt glemme disse mulighetene. For å redusere dette verditapet foreslår jeg at du setter opp regelmessige workshops for produktidéutvikling og bruker designrammeverk til å utvikle og videreutvikle løsningene dine.
De viktigste interessentene i dette møtet er produktdesignerne dine (eller ingeniørene hvis løsningen innebærer omfattende koding). Du kan vanligvis starte disse workshopene ved å presentere lysbilder eller en samarbeidsplattform som inneholder innsikten du har samlet inn knyttet til hypotesen.
(Intervjuverktøy har for øvrig denne funksjonen, så ikke bry deg med PowerPoint – bruk heller disse funksjonene.)
Deretter begynner du å komme opp med ulike funksjoner og designidéer som dekker situasjonen i hypotesen. Til slutt kan du bruke et hvilket som helst prioriteringsverktøy til å finne de mest verdifulle funksjonene fra listen og merke dem som «klare for backloggen».
Steg 4: Legg produktløsningene inn i veikartet ditt
Dette steget sier seg selv. Så snart UX-teamet har designene klare og du er ferdig med kravene til løsningen, legger du den til i backloggen og prioriterer den.
Kvalitativ dataanalyse er produktets superkraft!
Produktledere er brukernes stemme i alle selskaper. Takket være kunnskapen vår om brukernes behov og utfordringer veier produktledernes meninger tungt, og folk har en tendens til å være enige med oss. (Eller det burde de i det minste!)
Produktledere kan oppnå dette gjennom grundige prosesser for innsamling og analyse av kvantitative data. Men brukerintervjuer har én stor fordel. I møter med ledergruppen blir meningene dine uimotsigelige i det øyeblikket du siterer brukerne dine.
Sørg derfor for at alle intervjudataene dine er godt organisert og svært godt analysert!
Ikke glem å abonnere på nyhetsbrevet vårt for flere ressurser og veiledninger om produktledelse, i tillegg til de nyeste podkastene, intervjuene og annen innsikt fra bransjeledere og eksperter.