
Når ba kunder deg sist om å bygge en funksjon under et intervju, men ingen av dem endte opp med å bruke den? Jeg er overbevist om at hver eneste produktleder der ute har hatt minst én runde med brukerintervjuer som har endt i en kolossal fiasko.
Det naturlige neste spørsmålet er: Hva gikk galt under intervjuet? Mest sannsynlig støtte vi på en av de mange forskningsskjevhetene som førte til at vi tok feil produktbeslutninger.
Det er farlig å styre et produkt basert på skjeve data. Heldigvis kan du unngå dette ved å lære hva skjevhet er, hva som gjør den risikabel, og ved å lære av disse fem eksemplene på skjevhet i forskning som førte til uønskede resultater.
Hva er skjevhet i produktforskning, og hvilke risikoer innebærer det?
Begrepet skjevhet viser til settet med feil som produkt- og markedsføringsteam gjør når de gjennomfører forskning. Resultatet av disse feilene er vanligvis feilaktige analyser som fører til beslutninger som ikke gjenspeiler den faktiske situasjonen for produktet, markedet og brukerne deres.
En produktleders beslutninger har enorm innvirkning. Én enkelt beslutning kan endre retningen for hele produktlinjen mot et nytt marked eller en ny målgruppe. Det finnes også daglige beslutninger knyttet til gjennomføring som påvirker hvor effektive innsatsene til utviklings-, markedsførings-, AI- og andre team er.
Det er derfor spesielt farlig å ta beslutninger basert på skjeve data, ettersom du kan lede folk i feil retning og mislykkes fullstendig som PM.
Heldigvis er det ikke så vanskelig å redusere forskningsskjevhet som det kanskje kan virke. Den vanskelige delen er å innrømme at dataene dine er skjeve. Selve håndteringen er relativt enkel.
Typer forskningsskjevhet i kvantitativ dataanalyse
La oss begynne med de vanligste typene skjevhet du møter når du arbeider med data. De er vanligvis knyttet til feil i måten du samler inn, analyserer og handler på grunnlag av kvantitative data.
Klassisk vitenskapelig forskning identifiserer et bredt utvalg av forskningsskjevheter, blant annet:
- Publiseringsskjevhet
- Måleskjevhet
- Analyseskjevhet
- Designskjevhet
- Observatørskjevhet
- Gjenkallingsskjevhet
- Sosial ønskverdighetsskjevhet
- Demografisk og kulturell skjevhet
- Svarskjevhet og andre typer.
Men disse er litt for teoretiske til at vi kan snakke om dem her. Derfor vil jeg fokusere på de tre typene skjevhet du vil møte i virkeligheten som produktleder.
#1: Utvalgs- og seleksjonsskjevhet
Som navnet antyder, handler utvalgsskjevhet om å få feilaktige data på grunn av utvalget du har valgt.
Hvis utvalget ditt inneholder data som er skjevt fordelt mot en bestemt egenskap, vil analysen du gjør, ikke være representativ for den generelle befolkningen. Du vil ende opp med å ekstrapolere atferden til dette skjeve utvalget feilaktig og anvende den på hele datasettet.
Netflix er et av de store teknologiselskapene som har gjort seg skyldig i utvalgsskjevhet. Folk i USA likte anbefalingsalgoritmen deres fordi den klarte å foreslå serier som var relevante for interessene deres. Resten av verden hatet den imidlertid. Forslagene var rett og slett forferdelige.
Hva var årsaken? Tilsynelatende brukte AI-modellen som var trent til å lage disse forslagene, bare data om seere i USA og foreslo ting som var relevante for amerikanere.
Slik reduserer du utvalgsskjevhet
I Netflix' tilfelle begynte de ganske enkelt å tilføre internasjonale data til modellene sine og trente dem på nytt basert på en mindre skjev studiepopulasjon.
Men hvis du ønsker en mer systematisk tilnærming til å redusere denne typen skjevhet, kan jeg foreslå en litt uortodoks metode som har fungert for meg tidligere: å gjennomføre noe statistikere kaller en klyngeanalyse.
En klyngeanalyse kan finne fellestrekk i utvalgspopulasjonen din og gruppere dem basert på disse trekkene.
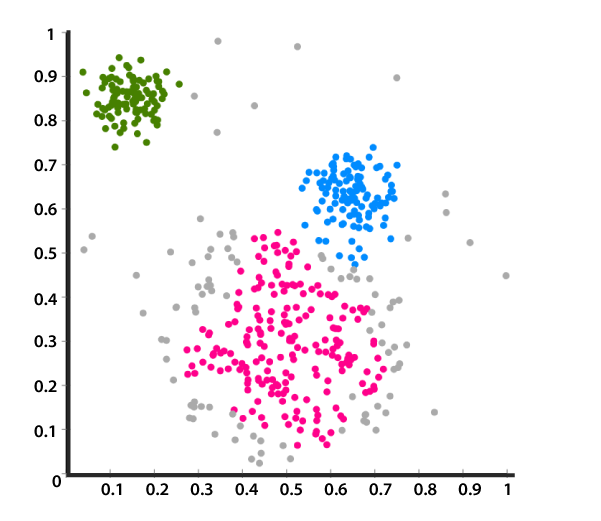
I bildet ovenfor kan du se at populasjonen tydelig er delt inn i tre forskjellige klynger basert på de valgte trekkene.
Det du gjør, er å velge et bredt utvalg av trekk og lage disse diagrammene for hvert av dem. Dataene dine vil være skjeve og utsatt for utvalgsskjevhet hvis du ser at du for enkelte trekk bare har én klynge. I eksempelet med Netflix hadde trekket seerens land én klynge: USA.
Vær imidlertid forsiktig! Noen ganger er det naturlig at hele populasjonen din har én enkelt klynge for en egenskap hvis den beskriver personaen deres. Hvis vi for eksempel gjennomførte en klyngeanalyse av leserne på theproductmanager.com, ville flertallet av dem vært produktledere. Dette er naturlig, ettersom produktledere er personaen nettstedet retter seg mot. Derfor bør du alltid fjerne slike egenskaper fra analysen din.
#2: Prosedyremessig skjevhet
Denne typen skjevhet viser til feilene du har gjort i studiedesignet og forskningsprosessen. Det kan skyldes at du bruker feil verktøy eller statistiske formler, eller til og med metodene du bruker for datainnsamling.
Etter min erfaring er prosedyremessig skjevhet spesielt utbredt i brukerundersøkelser. Hvis du har ledende spørsmål i undersøkelsen, vil respondentene dine mest sannsynlig bli offer for «dyttet» ditt mot en bestemt type svar.
Slik vil et typisk ledende spørsmål i en undersøkelse se ut:
Hvor mye elsker du produktet vårt?
Med denne formuleringen antyder du at brukerne bør gi et mer positivt svar, selv om de hater det du gjør.
En mer nøytral variant av det samme spørsmålet vil se slik ut:
Hvordan vil du vurdere produktet vårt?
I dette tilfellet viser vi tydelig at negative svar er helt greit.
Have an account? Log In
Slik reduserer du prosedyremessig skjevhet
Den beste måten å sikre at forskningen din er fri for prosedyremessig skjevhet på, er å velge riktige verktøy og metoder for den spesifikke typen analyse du gjennomfører.
Tilfeldig rekkefølge på svarene
Hvis du gjennomfører undersøkelser, må du i tillegg til å unngå ledende spørsmål også randomisere rekkefølgen på spørsmålene, fordi det er en risiko for at folk går lei halvveis gjennom spørreskjemaet og begynner å gi meningsløse svar. Uten randomisering vil de siste spørsmålene få nesten ingen nyttige svar.
Vær oppmerksom på statistisk signifikans
Husk også at undersøkelser delvis er kvantitative av natur. Derfor bør du ikke stole for mye på den statistiske analysen av disse dataene. Hvis du for eksempel forbedret en bestemt funksjon og NPS-resultatet økte med 2 %, er dette for liten forskjell til å kunne regnes som et statistisk signifikant resultat. En dobling ville derimot vært pålitelig.
Velg riktige verktøy
La oss også snakke om å velge feil verktøy. Hvis du måler konverteringsraten på betalingssiden din, vil bruk av et varmekartverktøy skape prosedyremessig skjevhet, ettersom dataene du får fra det, er upålitelige.
I slike tilfeller er det best å bruke varmekartprogramvare for å feilsøke atferdsproblemet og gjennomføre en A/B-test av atferdsendringen. Når det gjelder måling av CR, bør du derimot bruke produktanalyseverktøy som Amplitude eller GA4.
#3: Overlevelsesskjevhet
Skjeve forskningsmetoder har fulgt oss lenge. Det finnes en interessant historie om amerikanske bombefly fra andre verdenskrig. Hver gang bombeflyene returnerte til basen, undersøkte ingeniørene hullene etter luftvernskudd i skroget og markerte dem slik:
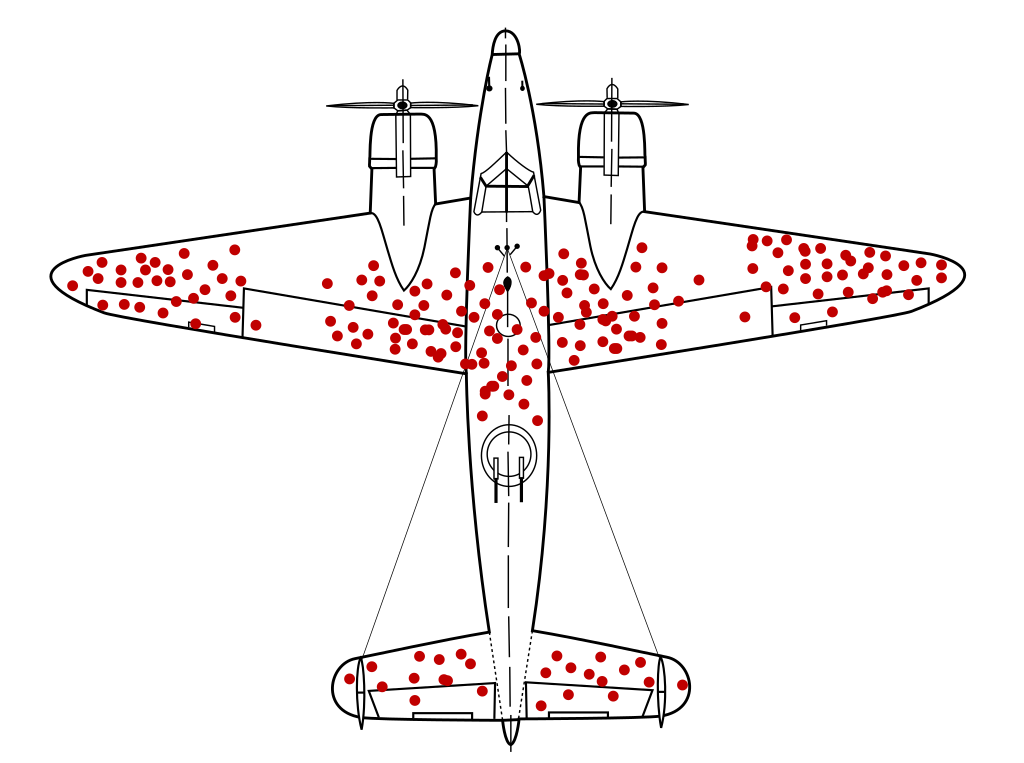
Det naturlige handlingsforløpet var å forsterke områdene med flest kuletreff med tykkere panserplater. Men denne forsterkningen hadde nesten ingen effekt på overlevelsesevnen til de amerikanske bombeflyene.
Etter å ha undersøkt saken nøye innså ingeniørene at de bare hadde med flyene å gjøre som hadde klart å overleve og returnere til basen. Delene de skulle forsterke, var derfor faktisk de områdene der flyene ikke hadde noen kulehull.
Slik reduserer du overlevelsesskjevhet
La oss gå fra flyene fra andre verdenskrig til digitale produkter. Som produktleder vil du, når du håndterer datainnsamlingsprosessen, mest sannsynlig møte disse to potensielle tilfellene der skjevhet sniker seg inn:
Filtrering av data for analyse
Når du analyserer brukeradferd, kan du ende opp med å filtrere bort brukere som har utført bestemte handlinger som ikke er relevante for analysen din.
Jeg opplevde dette tilfellet ganske nylig. Vi prøvde å forbedre aktiveringsraten for produktet vårt innen influencermarkedsføring. Dataanalyseteamet bygde en traktanalyse der konverteringsratene fra ett aktiveringstrinn til det neste var ganske høye (et sted mellom 50 og 70 %).
Disse dataene forvirret oss, fordi vi så en generell lav andel personer som engasjerte seg i produktet, sammenlignet med antallet registreringer. Etter å ha analysert dataene nøye forsto vi at datateamet hadde lagt inn et filter og bare beholdt dataene for storbrukerne våre.
Selvfølgelig var det mest sannsynlig superbrukerne som hadde kommet seg enkelt gjennom aktiveringsflyten. Derfor var konverteringsratene i trakten ikke egentlig representative for den reelle situasjonen. Da vi så på traktene og tok alle registreringene våre i betraktning, falt ratene betydelig.
Lærdom:
- Ta alltid hensyn til analysens kontekst og mål når du filtrerer dataene dine.
Analyse av forhåndssiltrede spørreundersøkelsesdata
Et annet interessant tilfelle innen forskningsdesign som jeg nylig måtte håndtere, var knyttet til en spørreundersøkelse vi gjennomførte for å forstå behovene og utfordringene til influencer-markedsførere. Igjen var studieresultatene litt forvirrende for oss fordi respondentenes behov ikke samsvarte med innsikten vi hadde fått fra brukerintervjuene våre.
Problemet her var forhåndssilingsprosessen vår for brukere som deltok i undersøkelsen. I tillegg til å spørre om de var influencere (for å unngå svar fra irrelevante personer), spurte vi også om størrelsen på publikummet/følgerbasen deres.
Av en eller annen grunn hadde vi diskvalifisert influencere med færre enn 50 000 følgere og bare tatt hensyn til svarene fra de relativt større influencerne. Produktet vårt skulle også rette seg mot små influencere. Dataene vi fikk fra undersøkelsen, var derfor ikke nøyaktige for oss.
Lærdom:
- Kontroller forskningsresultatene dine mot kvalitative data. Hvis det er stor forskjell mellom resultatene fra disse to, kan det hende du har gjort noe galt.
- Vær forsiktig med forhåndssilingsprosessen; du kan også ende opp med å diskvalifisere relevante brukere.
Typer skjevheter i kvalitativ forskning
Nå som de systematiske feilene knyttet til kvantitativ forskning er gjennomgått, går vi videre til en annen viktig kategori innen forskning – kvalitative studier.
For produktledere er den aller viktigste typen kvalitativ forskning intervjuer med brukere. Derfor vil jeg fokusere på de to viktigste skjevhetene du vanligvis møter når du snakker med kundene og brukerne dine.
Merk: Dette er også de to typene skjevheter du kan håndtere og redusere ved hjelp av et godt verktøy for produktidéer.
#4: Bekreftelsesskjevhet
En av de største styrkene til produktledere er å tro sterkt på noe når andre ikke gjør det. Det er slik du skaper innovative produkter og revolusjonerer bransjen din. Tendensen til å holde fast ved egne meninger er imidlertid også en stor svakhet hos PM-er.
Årsaken er at PM-er ofte rammes av bekreftelsesskjevhet. Dette beskriver en situasjon der du aktivt prøver å høre de delene av samtalen som samsvarer med overbevisningene dine, og forkaster resten.

Dette er ganske farlig for personer som deretter tar strategiske beslutninger om hvordan produktet skal se ut, og hvordan det skal lanseres i markedet. Når bekreftelsesskjevhet spiller inn, blir brukerintervjuene dine fullstendig meningsløse, og du ender opp med å ta beslutninger i blinde (og du kan glemme brukersentrering).
Slik reduserer du bekreftelsesskjevhet
Jeg må innrømme at jeg også er skyldig i å «praktisere» bekreftelsesskjevhet. Men det finnes en løsning som har hjulpet meg med å redusere den ganske effektivt.
Du kan kalle det en «kodegjennomgang» av brukerintervjuer. Det er en prosess der produkteksperter gjennomgår noen av kollegenes intervjuer sammen og foreslår å legge til eller fjerne innsikter.
Hvis du er den eneste produktlederen i selskapet (noe som er vanlig i små oppstartsbedrifter), kan du gjøre denne øvelsen sammen med gründeren din. Ikke glem at gründere i bunn og grunn også jobber med produkt.
#5: Deltakerskjevhet
Selv om bekreftelsesskjevhet er et farlig fenomen, er den blant de enkleste å korrigere. Den neste jeg vil snakke om, er imidlertid mye vanskeligere å redusere.
Deltakerskjevhet oppstår når respondentene dine sier ting basert på hva de tror du ønsker å høre, i stedet for hva de faktisk mener om det aktuelle temaet.
Når du for eksempel gjennomfører et intervju, kan du spørre forskningsdeltakerne om de ville kjøpt produktet ditt dersom du la til funksjonen de nettopp hadde bedt om. Kan du gjette hva svaret ville blitt? Basert på min erfaring vil det store flertallet svare ja.
Betyr det at du bør løpe til utviklingsteamet og be dem bygge denne funksjonen så snart som mulig? Nei! Spørsmålet du stilte, er mangelfullt og får naturlig nok folk til å si noe som vil gjøre deg fornøyd.
Jeg er enig i at funksjonen din vil kunne løse et stort problem for noen av disse intervjudeltakerne, og at de til slutt vil betale for den. Men flertallet vil ganske enkelt bruke funksjonen gratis eller ikke bruke den i det hele tatt.
I tillegg til å stille mangelfulle forskningsspørsmål vil studiedeltakere også gi deg skjevfordelte svar hvis du betaler dem for forskningsstudien. De har vanligvis en tendens til å «fortjene lønnen» ved å gi positive svar og gjøre deg fornøyd, uten å innse at de gjør mer skade enn gagn.
More Articles
Slik reduserer du skjevhet hos studiedeltakere
Som jeg allerede har nevnt, er det ganske vanskelig å redusere skjevhet hos studiedeltakere. Det er fordi du egentlig ikke vet om deltakeren er oppriktig med deg eller ikke.
Men to taktikker kan hjelpe deg med å redusere sjansen for å få dårlige svar.
Still spørsmål om tidligere erfaringer
Hvis du stiller spørsmål om en teoretisk hendelse i fremtiden, vil intervjuobjektene mest sannsynlig si ting som de aldri faktisk kommer til å gjøre i virkeligheten.
Hvis du spør noen 2. januar om de ville være villige til å gå på treningssenteret i 12 måneder på rad, vil de svare ja. Men vi vet alle at de fleste ender opp med å avslutte medlemskapet etter bare et par besøk.
For å unngå dette foretrekker produktledere å stille spørsmål om ting som har skjedd tidligere. På denne måten kan produktlederen lære om brukeratferd basert på det brukerne har gjort, og ikke på det de skulle ønske at de hadde gjort.
Still de riktige forventningene
Noen ganger tillater ikke spørsmålets eller studiens natur at du spør om brukernes fortid. Du ønsker for eksempel å vite hvordan de ville følt det hvis du økte prisen på produktet ditt.
I dette tilfellet kan du gjøre det tydelig at det er greit for deg å høre negative svar, og at deres ærlige tilbakemelding er den eneste måten de kan «gjøre seg fortjent til belønningen» på.
Å innrømme egne skjevheter er 80 % av kampen
Det stemmer. Det verste med å være forutinntatt er at de fleste av oss oppriktig tror at vi har rett. Derfor er det aller viktigste steget du kan ta for å redusere egne skjevheter, å erkjenne dem.
Så snart du gjør dette, vil du naturlig begynne å bekjempe dem og til slutt oppnå en tilstand uten skjevheter. (Eller i det minste en «skjevhetsstyrt» tilstand!)
Ikke glem å abonnere på nyhetsbrevet vårt for flere ressurser og veiledninger om produktledelse, samt de nyeste podkastene, intervjuene og annen innsikt fra bransjeledere og eksperter.