
Tekoäly on tällä hetkellä todennäköisesti teknologian maailman kuumin aihe.
Markkinoille tulee tekoälyyn perustuvia tuotteita, joista tulee yksisarvisyrityksiä tai jotka saavat satojen miljoonien dollarien rahoituksen. Lisäksi on julkkistuotejohtajia, jotka johtavat näitä tekoälyyn perustuvia tuotteita ja joita seuraamme ja joilta opimme.
Monet tuotejohtajat haluavat hyötyä tästä uskomattomasta teknologiasta joko johtamalla tekoälytuotetta tai lisäämällä tekoälyominaisuuksia olemassa oleviin tuotteisiinsa. Jos olet yksi heistä, tämä on sinulle.
Olen rakentanut useita tekoälytuotteita, ja olen täällä auttamassa sinua ymmärtämään tätä teknologiaa ja ottamaan siitä kaiken irti.
Mitä koneoppiminen on?
Koneoppiminen on tieteenala, joka keskittyy luomaan algoritmeja ja ohjelmistoja, jotka pystyvät ”oppimaan” antamastamme tiedosta ja suorittamaan tämän koulutuksen tuloksena tehokkaasti tietyntyyppisiä tehtäviä.
Termi ja koko ala ovat yllättävän vanhoja – ne juontavat juurensa vuoteen 1959, jolloin IBM:n Arthur Samuel (yksi aikansa merkittävistä tietojenkäsittelytieteilijöistä) otti termin käyttöön työssään ”Joitakin tutkimuksia koneoppimisesta tammipeliä käyttäen.”
Huolimatta 60-vuotisesta historiastaan koneoppimisesta on kuitenkin tullut suosittua vasta viime vuosikymmenen aikana laskentatehon valtavan kasvun ansiosta, erityisesti grafiikkasuorittimissa.
Mutta mitä tekemistä koneoppimisella on tekoälyn kanssa? Selvitetään se ensin.
Koneoppiminen (ML) vs. tekoäly (AI)
Kaikki käyttävät termejä ”koneoppiminen” ja ”tekoäly” toistensa synonyymeina viitatessaan älykkäisiin ohjelmistoihin, jotka pystyvät tunnistamaan kohteita kuvista, kirjoittamaan runoja ja tuottamaan vaikuttavia vastauksia yksityiskohtaisiin kehotteisiin.
Tekoäly on kuitenkin laajempi käsite, joka tarkoittaa koneita, joilla on havaitsemis- ja päättelykyky, kun taas koneoppiminen on tekoälyn osa-alue, joka keskittyy oppimaan kykeneviin ohjelmistoihin.
Nyt kun termien määritelmät ovat selvillä, siirrytään ymmärtämään, miten nämä koneet oppivat ja mitkä ovat niiden toiminnan perusteet.
Miten koneoppiminen toimii?

Ymmärtääksemme koneoppimista meidän kannattaa ensin tarkastella sen yleisintä muotoa – syväoppimisen neuroverkkoja.
Neuroverkko on tavallisella koodilla kirjoitettu rakenne, joka pyrkii jäljittelemään biologisten aivojen toimintaa. Ihmisillä ja muilla elävillä olennoilla aivot ovat monimutkainen toisiinsa yhteydessä olevien hermosolujen verkosto, jossa yhden solun impulssi aktivoi toisen ja tieto kulkee hermosolujen verkostoa pitkin.
En usko olevani oikea henkilö selittämään biologiaa (epäonnistuisin siinä surkeasti), joten pitäydyn teknologiassa.
Ohjelmistojen neuroverkot näyttävät jotakuinkin tältä:
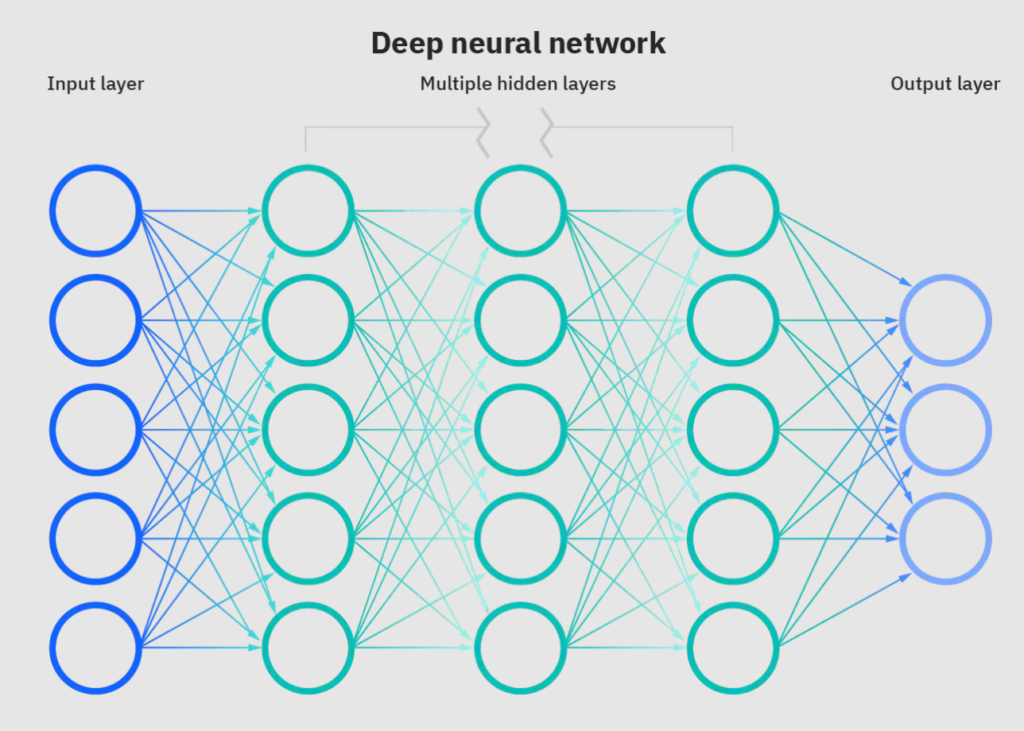
Jokainen ympyrä tässä kuvassa on yksittäinen hermosolu. Koodissa hermosolu on yksinkertaisesti funktio, joka voi vastaanottaa jonkinlaista tietoa, käsitellä sitä ja välittää tuloksen seuraavalle hermosolulle.
Huomautus: tämä on todellisen prosessin yksinkertaistus. Lisätietoja saat katsomalla poikkeuksellisen hyvän neuroverkkoja käsittelevän videoluennon YouTube-kanavalla 3blue1brown, jossa selitetään myös tämän teknologian taustalla olevat matemaattiset käsitteet.
Kuten yllä olevasta kuvasta näemme, hermosolumme on järjestetty kerroksiksi. Neuroverkoissa on yleensä kolmenlaisia kerroksia:
- Syötekerros vastaanottaa tietoa ulkomaailmasta.
- Piilokerrokset käsittelevät tätä tietoa siten, että kukin niistä käsittelee yhtä sen osa-aluetta.
- Tulostekerros palauttaa käsitellyn tuloksen ulkomaailmaan.
Ymmärretään nyt näiden kerrosten merkitys yksinkertaisen esimerkin avulla. Kuvitellaan, että haluat neuroverkon tunnistavan eläimen valokuvasta. Tätä varten olet suunnitellut kuudesta kerroksesta koostuvan neuroverkon, joka toimii seuraavalla tavalla:
- Syöttökerros ottaa vastaan pieniä osia eläimen valokuvasta ja välittää ne ensimmäiseen piilokerrokseen.
- Ensimmäinen piilokerros yrittää löytää kustakin osasta perusmuotoja (esimerkiksi suoria viivoja) ja välittää nämä tiedot seuraavalle kerrokselle.
- Toinen kerros yhdistää sitten osan näistä viivoista geometrisiksi perusmuodoiksi (esimerkiksi ympyröiksi, puoliympyröiksi ja niin edelleen) ja välittää ne kolmannelle kerrokselle.
- Kolmas kerros muodostaa näistä geometrisista muodoista monimutkaisempia muotoja.
- Neljäs kerros yhdistää kaikki aiemmin muodostetut muodot ja muodostaa eläimen ääriviivat.
- Ulostulokerros antaa lopuksi muodon perusteella eläimen tyypin, jonka se on tunnistanut.
Tältä se näyttää visuaalisesti.
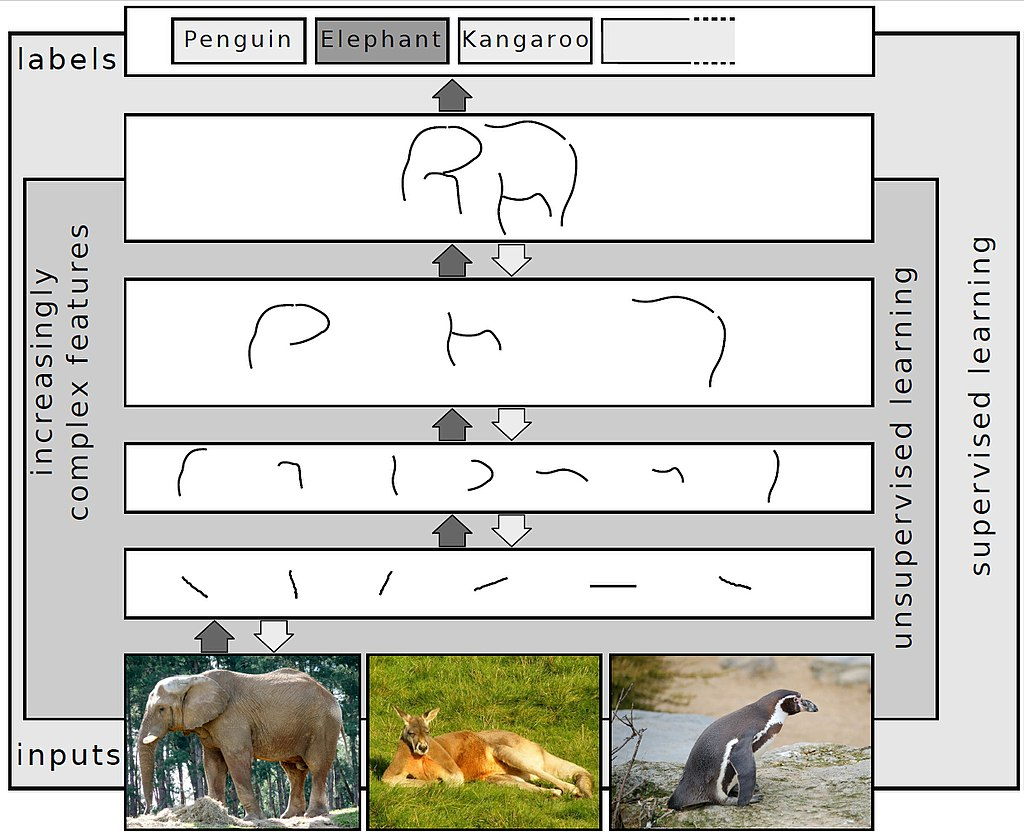
Kun tarkastelet yllä kuvattua prosessia, saatat ihmetellä, miten tekoälyinsinöörit saavat nämä kerrokset tunnistamaan muotoja ja arvaamaan kuvassa olevan eläimen, eikö niin? He tekevät sen ”kouluttamalla” neuroverkkoa suorittamaan tehtävänsä.
Kouluttaakseen verkkoa tekoälyinsinöörit antavat sille joukon syötteitä ja niitä vastaavat oikeat tulosteet. Tässä tapauksessa syötteinä olisi useita kuvia eläimistä ja tulosteina samat kuvat sekä oikea eläintyyppi.
Koska verkollasi on oikeat vastaukset, se hienosäätää jatkuvasti itseään (parametreja, joita kukin neuroni välittää muille), kunnes sen vastaukset muistuttavat hyvin paljon antamiamme oikeita vastauksia.
Oikeassa elämässä verkkosi ei koskaan ole vastaustensa suhteen sataprosenttisen tarkka, ja huomioon on aina otettava jonkinasteinen virhe. Hyvä uutinen on, ettet oikeastaan halua vastausten olevan sataprosenttisen oikeita. Sinulle on tärkeää vain, että malli on ihmistä nopeampi ja tarkempi.
Nyt kun ymmärrämme, miten se toimii, siirrytään tarkastelemaan, miten voit käyttää koneoppimista tuotteissasi.
Koneoppiminen: mitä sillä voi tehdä ja mitä ei

Tekoälyyn liittyvä hype on valtavaa, ja monet startup-yritysten perustajat tai tuotepäälliköt haaveilevat tekoälyn lisäämisestä tuotteisiinsa. Mutta tässä on miljoonan dollarin kysymys: tarvitsetko todella tekoälyä?
Ymmärrän, että termi ”tekoälyohjattu” näyttää hyvältä minkä tahansa tuotteen sijoittajille suunnatussa esityksessä ja markkinointimateriaaleissa, mutta älä unohda, että tekoälymallin rakentaminen on kallista ja aikaa vievää.
Jos tekoälymallisi siis pyrkii ratkaisemaan perustavanlaatuisen ongelman, jonka olisit voinut hoitaa helposti tavallisella koodilla, tuhlaat lopulta varojasi verkkosivustosi näyttävään termiin.
Ymmärtääksemme, tarvitsetko tekoälymallia, tarkastellaan tehtäviä ja ongelmia, joita voit käsitellä sen avulla, ja verrataan niitä ongelmiin, jotka sinun pitäisi ratkaista tavallisella ohjelmoinnilla.
Have an account? Log In
Yleiset tehtävät, joita koneoppimismallit voivat hoitaa puolestasi
ML-mallit eivät ole taikuutta – vaikka se varmasti vaikuttaa siltä, kun tarkastellaan kaikkia tapoja, joilla voit käyttää ChatGPT:tä ja muita uusia suuria kielimalleja. Vaikka kehittyneiden tekoälytyökalujen käyttö on lisääntymässä, monet tuotteet voivat hyötyä yksinkertaisemmista ML-malleista.
Näiden mallien suorittamat toiminnot kuuluvat yleensä johonkin seuraavista neljästä luokasta.
Luokittelu
Kuten nimi kertoo, nämä mallit pystyvät tunnistamaan niille antamasi tiedot ja luokittelemaan ne tai antamaan niille tunnisteen. Aiemmin käsittelemämme esimerkki eläinten tunnistamisesta kuvasta on tyypillinen tekoälyluokittelun käyttötapaus.
Tekoälyluokittelu jakautuu puolestaan neljään tyyppiin:
Binäärinen luokittelu: Tämä malli antaa vastaukseksi kyllä tai ei. Yleisiä käyttötapauksia ovat sähköpostin roskapostin tunnistimet (isSpam = true tai false), rintasyövän diagnosointi (riskialtis tai ei riskialtis) ja niin edelleen.
Epätasapainoinen luokittelu: Nämä mallit jakavat tiedot kahteen ryhmään: normaaliin enemmistöön ja poikkeavaan vähemmistöön. Esimerkki tästä on tulliselvityksissä tapahtuvien petosten tunnistaminen valtioiden rajoilla.
Tekoälymalli tutkii asiakirjat ja antaa kullekin tulliselvitykselle vihreän (kaikki kunnossa), keltaisen (asiakirjat on tarkastettava) tai punaisen (tavarat on tarkastettava) merkinnän sen perusteella, kuinka ”normaaleilta” asiakirjat vaikuttavat muihin verrattuna.
Moniluokkainen luokittelu: Tässä tapauksessa malli valitsee yhden monista ennalta määritetyistä arvoista. Optisen merkintunnistuksen algoritmit (eli algoritmit, jotka poimivat tekstin kuvasta) kuuluvat tähän tyyppiin.
Monitunnisteinen luokittelu: Toisin kuin edellisessä tapauksessa, nämä mallit määrittävät samalle tietokokonaisuudelle useita tunnisteita. Monet konenäköalgoritmit kuuluvat tähän luokkaan, koska ne tarkastelevat kuvaa tai videota ja tunnistavat siitä useita kohteita. Tältä monitunnisteinen luokittelu näyttää itseohjautuvassa autossa.
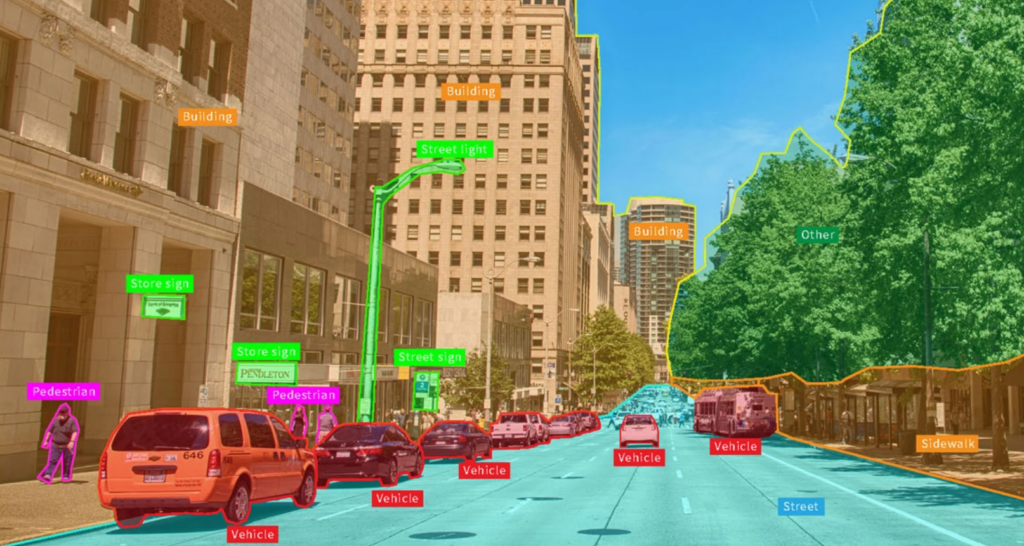
Muita tämän teknologian sovelluksia ovat hyödyllisen tiedon poimiminen tekstistä (esimerkiksi mielipiteet brändistäsi twiiteistä) tai keskustelunaiheiden paikantaminen podcastista.
Regressio
Tämä tekoälymallien luokka pystyy tekemään ennusteita olemassa olevan tiedon perusteella. Regressiomallien avulla voit ymmärtää useiden tekijöiden välisiä suhteita sekä ennustaa tulevia arvoja aiempien arvojen perusteella (eli ennustamisalgoritmeilla).
Regressioalgoritmien käyttökohteita ovat muun muassa:
- Osakekurssin ennustaminen aiemman hintavaihtelun perusteella.
- Auton hinnan ennustaminen ajokilometrien, valmistusvuoden ja muiden tekijöiden perusteella.
- Parhaiden mainostekstien ehdottaminen paremman konversioasteen saavuttamiseksi.
- Parhaan viikonpäivän ja ajankohdan löytäminen sähköpostien lähettämiseen, jotta mahdollisimman moni vastaanottaja avaisi viestin ja napsauttaisi sen linkkejä.
Jotkin suuremmista malleista pystyvät ennustamaan myös niinkin monimutkaisia ja kaoottisia asioita kuin sää.
Ryhmittely
Tämä on valvomattomaan oppimiseen perustuva prosessi, jossa malli havaitsee samankaltaisuuksia kohteiden joukossa ja ryhmittelee ne näiden samankaltaisuuksien perusteella. Toisin kuin luokittelussa, ryhmittelyalgoritmi ei tiedä, mitä se tarkastelee. Se tietää vain, että nämä kohteet muistuttavat toisiaan.
Ryhmittelyalgoritmien käyttökohteita ovat esimerkiksi:
- Sähköpostimarkkinointilistan ryhmitteleminen samalla tavalla käyttäytyviin segmentteihin.
- Suuren kirjajoukon järjestäminen aihealueisiin.
- Valokuvien ryhmitteleminen niiden sisältämien kohteiden perusteella.
Yleisesti ottaen ryhmittelyalgoritmeja tarvitaan silloin, kun sinulla on suuri joukko kohteita, jotka haluat jakaa eri ryhmiin tietyn ominaisuuden perusteella.
Synteesi
Lopuksi käsittelemme algoritmeja, jotka pystyvät luomaan sisältöä. Puhumme tekoälytaiteilijoista, -kirjoittajista ja -muusikoista.
Tämän malliryhmän käyttökohteet ovat todennäköisesti rajattomat, ja mallit (joihin viitataan nykyään suurina kielimalleina eli "LLM-malleina") kehittyvät joka päivä. Tähän ryhmään kuuluvat esimerkiksi:
- Verkkosivujen tekstintuottajat, jotka luovat hakukoneoptimointia varten optimoitua rakennetta ja sisältöä.
- Vesileiman poistaminen kuvasta ja vesileiman alla olleen kuvan osan piirtäminen.
- Uusien ruutujen luominen peliin sen sijaan, että näytönohjain renderöisi ne, jolloin resursseja säästyy.
- Lisenssimaksuttomien valokuvien luominen mainoksia varten.
Tässä on esimerkki runosta, jonka pyysin GPT-4:ää kirjoittamaan. (Huomautus: Esitin saman kysymyksen GPT-3:lle tammikuussa, ja voin vakuuttaa, että se on nykyään paljon lahjakkaampi.)
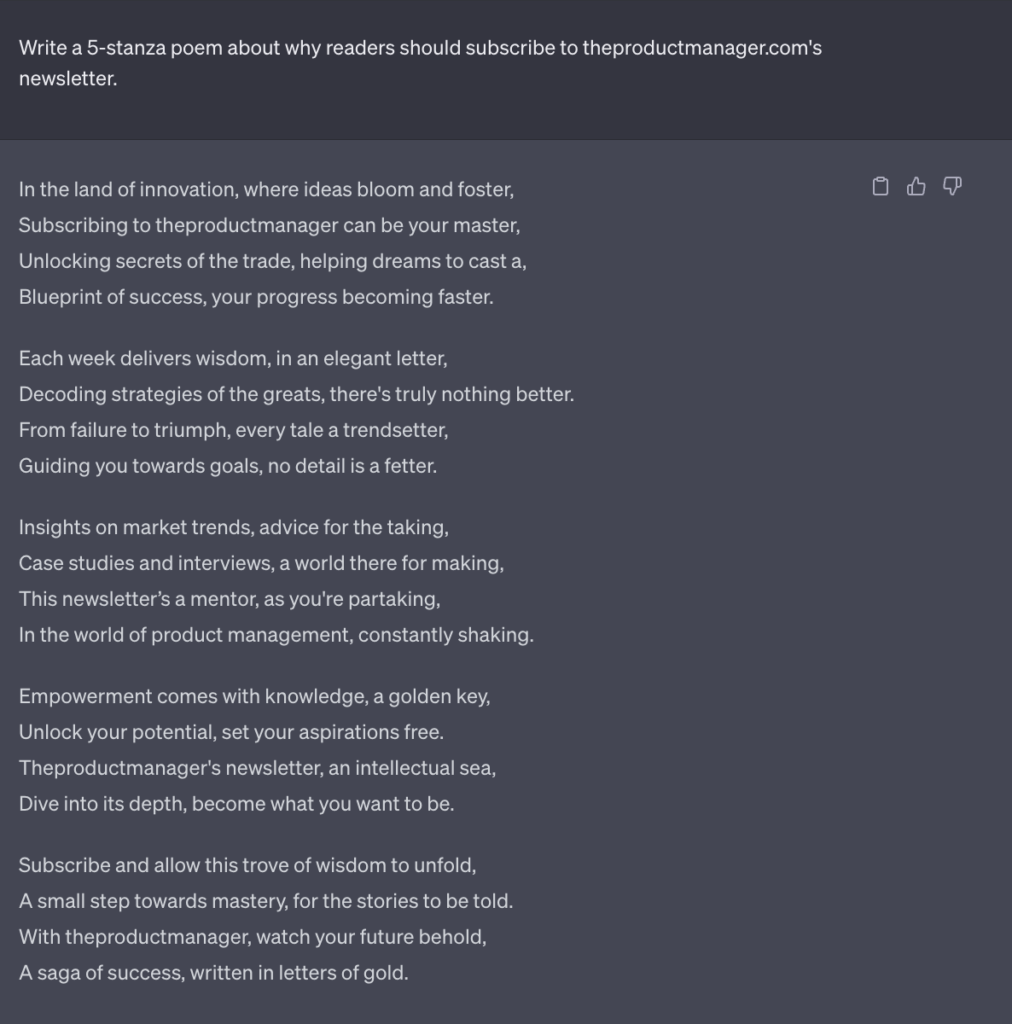
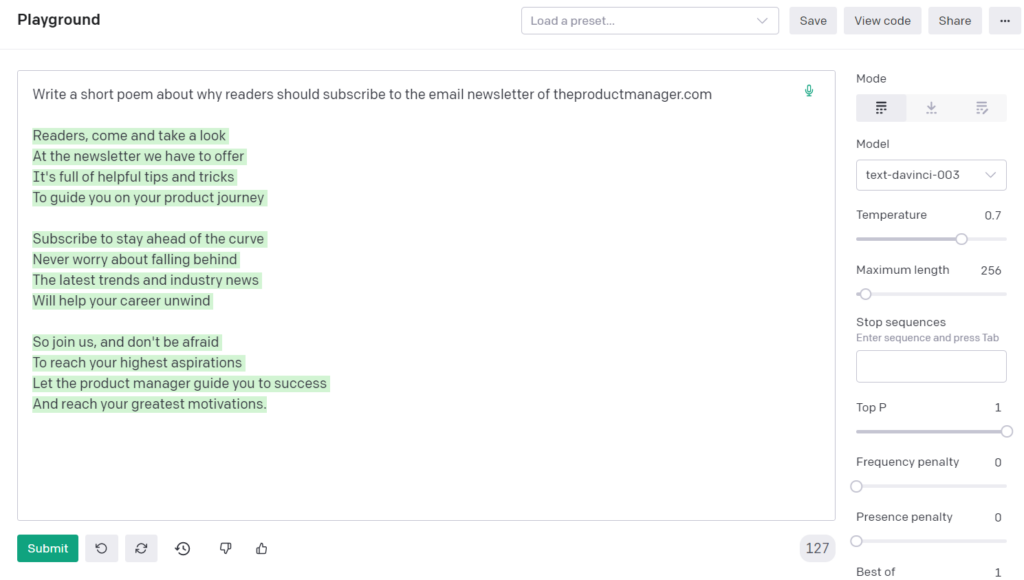
Voit muotoilla kehotteen luonnollisella kielellä, ja malli ymmärtää pyyntösi ja toteuttaa sen internetistä keräämänsä tiedon perusteella.
Yhteenvetona nämä ovat tekoälymallien yleisimmät sovellustyypit.
Tekoälyllä voi tehdä monia asioita, mutta joskus mallin rakentamisesta luopuminen ja yksinkertaiseen ohjelmistotuotekehitykseen turvautuminen on nopeampaa ja halvempaa.
Tehtävät, joissa kannattaa käyttää tavallista ohjelmointia
Kaikkien ongelmien ratkaisemiseen ei tarvita tekoälymallia.
Voit selvittää, pystytkö ratkaisemaan käsillä olevan ongelman ilman tekoälyä, kysymällä itseltäsi, onko ongelman ratkaisemiseksi olemassa deterministinen ja selkeä joukko sääntöjä tai toimintoja, joita voit noudattaa.
- Jos vastaus on kyllä, voit käyttää tavallista koodia (onhan koodi yksinkertaisesti joukko selkeitä sääntöjä ja komentoja tietokoneellesi). Sinun ei esimerkiksi tarvitse käyttää tekoälyä selvittääksesi, onko käyttäjiesi lataama tiedosto Excel-laskentataulukko, sillä XLSX-tiedostoilla on tiukka rakenne ja voit tarkistaa sen.
- Kun et pysty osoittamaan tällaisia selkeitä sääntöjä, sinun on turvauduttava tekoälymalleihin, jotka käsittelevät tehtävän puolestasi. Ilmeinen esimerkki tästä on kuvantunnistus. Ei ole olemassa luotettavaa sääntöjoukkoa, jonka avulla voisit ymmärtää, onko kuvassa näkyvä punainen asia tietyn merkkinen auto.
Selkeytetään tätä käsitettä tarkastelemalla muutamia ongelmia, jotka voit ratkaista ilman tekoälyä.
Lyhimmän reitin löytäminen kartan pisteestä A pisteeseen B. Tämä on tunnettu matematiikan ongelma, ja sen ratkaisemiseen on paljon deterministisiä lähestymistapoja (esimerkiksi Dijkstran algoritmi), jotka voidaan toteuttaa tavallisella koodilla.
Liikenneruuhkien tarkistaminen kartalta. Tähän on kekseliäs ratkaisu. Google esimerkiksi kerää reaaliaikaiset GPS-sijaintitiedot kaikista älypuhelimista (joissa tämä ominaisuus on käytössä) ja tarkistaa, onko kadulla paljon paikallaan olevia puhelimia. Jos näin on, kyseessä täytyy olla liikenneruuhka.
Huomautus: Tässä voit kuitenkin käyttää tekoälyä ennustamaan liikenneruuhkan kadulla, jolla älypuhelimia on hyvin vähän tai niiden sijainnit ovat hajallaan.
Brändimainintojen laskeminen sosiaalisessa mediassa. Jos haluat tietää, kuinka monta kertaa brändisi mainitaan sosiaalisen median alustoilla, tarvitset vain kaavintatyökalun, joka lukee sosiaalisen median hakutulokset ja laskee maininnat.
Huomautus: Tekoälymallista olisi tässä hyötyä mainintojen määrän ennustamisessa kaapimalla pieni osa tuloksista (koko hakutulosluettelon sijaan), mikä säästäisi laskentatehoa ja resursseja.
Yhteenvetona voidaan todeta, että tekoälymallit pystyvät suoriutumaan varsin hyvin tehtävistä, joita niillä voidaan teettää, mutta joskus koodin kirjoittaminen on helpompaa.
Nyt kun ymmärrät, miten tekoälyä käytetään tuotteissasi, siirryn jakamaan muutamia vinkkejä tekoälymallien parissa työskentelyyn.
6 vinkkiä koneoppimisen parissa työskenteleville tuotepäälliköille
Koneoppimistuotteiden parissa työskentelemäni uran aikana olen tehnyt paljon virheitä, jotka ovat johtaneet ajan ja rahan menetykseen. Jotta sinä, ML-tuotepäällikkö, et toistaisi näitä virheitä, tässä on muutamia hyödyllisiä vinkkejä, jotka kannattaa ottaa huomioon.
Datan laatu ratkaisee malliesi onnistumisen tai epäonnistumisen
ML-insinööritiimit ja datatieteilijät käyttävät mielellään sanontaa ”roskaa sisään – roskaa ulos”. Se tarkoittaa, että mallin laatu riippuu suoraan sen kouluttamiseen käyttämiesi aineistojen laadusta.
Ymmärtääksesi, mitä tarkoitan huonolla datalla, käyn läpi joitakin sen laatuun vaikuttavia tekijöitä:
Huonot annotaatiot: Annotointi on uusien tietojen manuaalista merkitsemistä, jotta niitä voidaan käyttää mallin koulutuksessa ”oikeina tuloksina”. Esimerkiksi eläimiä tunnistavan mallin annotaattorit korostavat kuvassa olevan eläimen ja merkitsevät sen nimellä. Jos merkitset norsut ”pingviineiksi”, mallisi tekee koulutuksen jälkeen samoin.
Monimuotoisuuden puute: Mallisi toimivat hyvin vain, jos todellisen maailman data muistuttaa niitä tietoja, joilla ne on koulutettu. Jos sinulla on rekisterikilpien tunnistusjärjestelmä, joka on oppinut lukemaan ainoastaan Yhdysvaltojen rekisterikilpiä, se epäonnistuu surkeasti nähdessään EU-rekisterikilvillä varustetun auton.
Datan vinouma: Oletko koskaan kuullut rasistisesta tekoälystä? Google on hiljattain pyytänyt anteeksi afroamerikkalaiselta yhteisöltä, koska sen tietokonenäköalgoritmi teki näin:
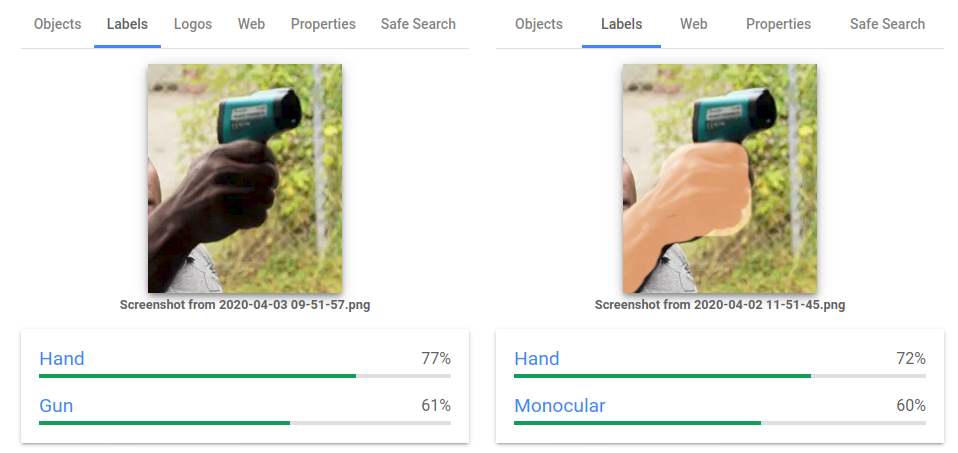
On myös lukuisia tapauksia, joissa poliisin tekoälymallit ovat kohdistuneet vähemmistöihin.
Syy tähän on vinoutunut data. Nämä poliisin tekoälyjärjestelmät käyttivät poliisiaseman tietokantaa, joka oli tunnettu rodullisesta puolueellisuudestaan. Siksi tietokannassa oli paljon tietoa vähemmistöihin kohdistuneista pidätyksistä, mikä johti siihen, että tekoälymalli kohdisti toimintansa heihin.
Varmista siis, ettei käyttämäsi data sisällä vinoumia, jotka voivat johtaa epäkunnioittavaan tai loukkaavaan toimintaan tai vielä pahempaan.
Rakenna ominaisuuksia, joiden avulla voit kouluttaa mallisi uudelleen
Mallien rakentaminen on vasta puolet työstä – niitä on myös jatkuvasti parannettava lisäämällä uusia ominaisuuksia tai yksinkertaisesti tarjoamalla niille uutta dataa uudelleenkoulutusta varten.
ML-tuotteesi uudelleenkoulutukseen soveltuvan datan löytäminen voi olla haastavaa. Harkitse siis sellaisten ominaisuuksien lisäämistä, joiden avulla voit saada kyseistä dataa itse tuotteesta.
Tässä on kaksi palautesilmukkamenetelmää, joita olen kokeillut ja jotka toimivat hyvin:
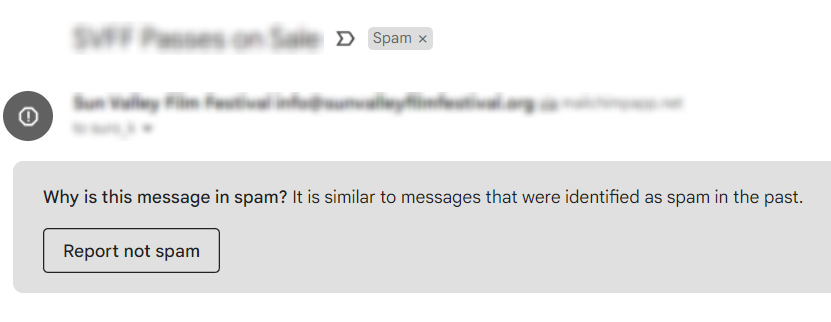
Palautteen pyytäminen tekoälyn tuloksista: Jos tunnistat sähköposteista roskapostia, lisää käyttäjille “ei roskapostia” -painike, jolla he voivat poistaa sähköpostin roskapostin joukosta. Tämän toiminnon seurauksena he myös “merkitsevät” sähköpostin roskapostista vapaaksi, ja voit käyttää sitä mallisi uudelleenkouluttamiseen.
Huomautus: Kyllä, juuri tätä Gmailin “Ilmoita, ettei kyseessä ole roskaposti” -painike tekee.
Tarjoa käyttäjälle mahdollisuus hienosäätää malliasi hänen datansa avulla: Tämä on molemmille osapuolille hyödyllinen ratkaisu. Käyttäjäsi saavat paremmin toimivan mallin, koska olet kouluttanut sen uudelleen heidän erityisellä datallaan, ja sinä saat lisää dataa mallisi monimuotoisuuden kasvattamiseksi.
Jos mahdollista, käytä valmiita ratkaisuja omien rakentamisen sijaan
Sinun ei tarvitse keksiä tekoälyn pyörää uudelleen. Saatavilla on paljon valmiita malleja, joita voit ostaa tai vuokrata. Tämä on erityisen olennaista, jos yrität ratkaista suhteellisen yleistä ongelmaa, kuten alastonkuvien tunnistamista sosiaalisen median sovelluksessasi.
Voit löytää valmiita malleja esimerkiksi alustoilta Modelplace ja RapidAPI Hub.

Yksinkertainen logontunnistusmallin haku toi esiin yhdeksän valmista ratkaisua, jotka voimme integroida API:n avulla.
Käytä avoimen lähdekoodin tekoälymalleja ja osallistu niiden kehittämiseen
Tekoälyllä on merkittävä avoimen lähdekoodin yhteisö. Voit hyödyntää sitä löytääksesi joko valmiita malleja tai hyödyllisiä työkaluja omien malliesi rakentamiseen.
Voit tutustua tähän GitHubin luetteloon, josta löydät joitakin parhaista saatavilla olevista avoimen lähdekoodin koneoppimisprojekteista ja -hankkeista. Luettelo on varsin monipuolinen ja sisältää:
- Malleja, joiden selitettävyys vaihtelee (eli kuinka hyvin voit selittää mallisi toimintatavan) ja jotka on kirjoitettu Pythonilla ja C:llä. Niiden kehittäjiin kuuluu esimerkiksi IBM:n ja Amazonin kaltaisia jättiyrityksiä.
- Opetusdataa mallejasi varten.
- Työkaluja data-analyysiin, keskeisten mittareiden seurantaan, poikkeamien tunnistamiseen ja muuhun.
Huomautus: Jos olet tehnyt näihin malleihin parannuksia, lähetä pull request ja jaa työsi avoimen lähdekoodin yhteisön ja sen sidosryhmien kanssa. Avoimessa lähdekoodissa on kyse mahtavista ihmisistä, jotka tekevät mahtavia asioita ja jakavat niitä muiden kanssa.
More Articles
Tekoälymallien rakentaminen vie aikaa
Agilen ja MVP:n menetelmät eivät aina toimi ML-järjestelmien kanssa. Et voi aina rakentaa pientä mallia ja lisätä siihen uusia ominaisuuksia useiden iteraatioiden avulla. Joskus mallin pieni muuttaminen tarkoittaa, että se on koulutettava uudelleen alusta alkaen.
Saatat jopa kohdata tilanteen, jossa mallin optimointi 10 prosentilla tarkoittaisi vanhan mallin hylkäämistä ja uuden koneoppimisalgoritmin luomista.
Toinen huomioitava asia on data-ammattilaisten tai monialaisten tiimien työn erityisluonne, kun tällaisia asiantuntijoita kuuluu tiimiin.
Joskus he eivät pysty antamaan arviota työnsä valmistumisajasta, koska suurin osa heidän ajastaan kuluu jonkin täysin uuden keksimiseen eivätkä he tiedä, kuinka paljon aikaa kehitysprosessi vie. (Tästä on hyvänä esimerkkinä Googlen Geminin julkaisuaikataulun jatkuva muuttuminen.)
Vältä tietokantasi rakenteen suuria muutoksia
Tämä on tuskallinen todellisuus, jonka olen joutunut kohtaamaan muutaman kerran.
Jos käytät omaa dataasi malliesi uudelleenkouluttamiseen, vältä tietokantasi rakenteen muuttamista.
Mallisi rakennetaan käsittelemään rakenteeltaan ja tyypiltään tietynlaista dataa, joten jos datatekniikkatiimisi muuttaa tietokantojasi, ML-tiimisi joutuu muuttamaan mallejasi ja jopa kouluttamaan ne uudelleen alusta alkaen.
Oppiminen on jatkuva prosessi.
Tekoäly on tehnyt maailmasta paremman paikan meille kaikille, sillä se on auttanut monia visionäärisiä perustajia ja ML-tuotepäälliköitä ratkaisemaan ongelmia, jotka vaikuttivat aiemmin mahdottomilta.
Toivon, että tämä opas on auttanut sinua ymmärtämään tekoälyn merkityksen tuotehallinnassa, tuotepäällikön roolin tässä prosessissa sekä käytännön tapoja, joilla yritykset voivat hyödyntää tekoälyä.
Uusien loistavien tuotteiden kehittäminen ei kuitenkaan ole pelkästään tekoälyn asianmukaista hyödyntämistä. Sinun on hallittava myös monia muita tärkeitä tuotteen osa-alueita, kuten:
- elinkelpoisten vähimmäistuotteiden rakentamisen taito.
- Tiimisi työn asianmukainen suunnittelu tuotesuunnitelmien avulla.
- Oman PMF:si löytäminen kustannustehokkaasti ja niin edelleen.
Lopuksi, kuten GPT-3-esittelyn runo on vihjannut, voit tilata uutiskirjeemme saadaksesi tuotehallinnan parhaat sisällöt ja pysyäksesi kehityksen kärjessä.