
Kunstig intelligens er sandsynligvis det hotteste emne i teknologiens verden lige nu.
Du ser AI-drevne produkter blive enhjørningsvirksomheder eller sikre sig hundredvis af millioner i risikovillig kapital. Der er også kendte produktledere, som står i spidsen for disse AI-drevne produkter, og som vi følger og lærer af.
Mange produktchefer derude ønsker at drage fordel af denne utrolige teknologi ved enten at lede et AI-produkt eller tilføje AI-funktioner til deres eksisterende produkter. Hvis du er en af dem, er dette til dig.
Jeg har bygget flere AI-produkter, og jeg er her for at hjælpe dig med at forstå denne teknologi og få mest muligt ud af den.
Hvad er maskinlæring?
Maskinlæring er en disciplin, der fokuserer på at skabe algoritmer og software, som er i stand til at “lære” af de oplysninger, vi giver dem, og som effektivt kan udføre bestemte typer opgaver som følge af denne træning.
Selve begrebet og fagområdet er overraskende gamle—det går tilbage til 1959, hvor Arthur Samuel fra IBM (en af datidens fremtrædende dataloger) introducerede det i sit arbejde "Nogle undersøgelser af maskinlæring ved hjælp af damspillet."
På trods af sin 60 år lange historie er maskinlæring dog først blevet populært i løbet af det seneste årti takket være den massive stigning i computerkraft, især i GPU’er.
Men hvad har maskinlæring at gøre med kunstig intelligens? Lad os komme videre ved at få det af vejen.
Maskinlæring (ML) kontra kunstig intelligens (AI)
Alle bruger begreberne “maskinlæring” og “kunstig intelligens” i flæng om intelligent software, der er i stand til at genkende elementer på billeder, skrive digte og generere imponerende svar på detaljerede prompter.
Kunstig intelligens er dog det bredere begreb for maskiner med evnen til perception og ræsonnement, mens maskinlæring er en delmængde af AI, der fokuserer på software, som kan lære.
Nu hvor vi har gennemgået definitionerne af begreberne, kan vi gå videre til at forstå, hvordan disse maskiner lærer, og de grundlæggende principper for, hvordan de fungerer.
Sådan fungerer maskinlæring

For at forstå maskinlæring bør vi først gennemgå den mest almindelige form—neurale netværk baseret på dyb læring.
Et neuralt netværk er en struktur skrevet i almindelig kode, som forsøger at efterligne funktionen af en biologisk hjerne. Hos mennesker og andre levende væsener er hjernen et komplekst netværk af neuroner (nerveceller), der er forbundet med hinanden, hvor en impuls fra én celle aktiverer en anden, og informationen bevæger sig langs netværket af neuroner.
Jeg tror ikke, jeg er den rette person til at forklare biologi (da jeg ville dumpe helt håbløst i det), så jeg holder mig til teknologien.
De neurale netværk i software ser nogenlunde sådan ud:
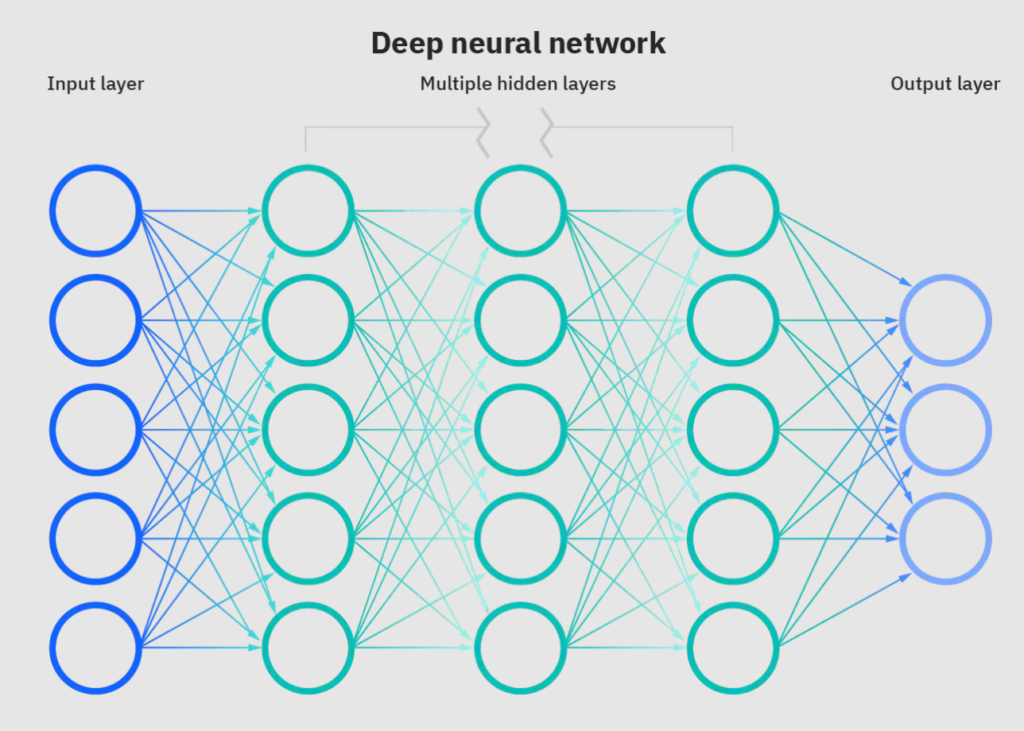
Hver cirkel her er en enkelt neuron. I kode er en neuron blot en funktion, der kan modtage en eller anden form for information, behandle den og sende et resultat videre til den næste neuron.
Bemærk: Dette er en forenkling af den virkelige proces. Hvis du vil vide mere, kan du se den fremragende videolektion om neurale netværk på YouTube-kanalen 3blue1brown, hvor de også forklarer de matematiske begreber bag denne teknologi.
Som vi kan se på billedet ovenfor, er vores neuroner organiseret i lag. Neurale netværk har normalt tre typer lag:
- Inputlaget, som er ansvarligt for at modtage information fra den ydre verden.
- De skjulte lag behandler denne information, hvor hvert lag behandler ét enkelt aspekt af den.
- Outputlaget sender det behandlede resultat tilbage til den ydre verden.
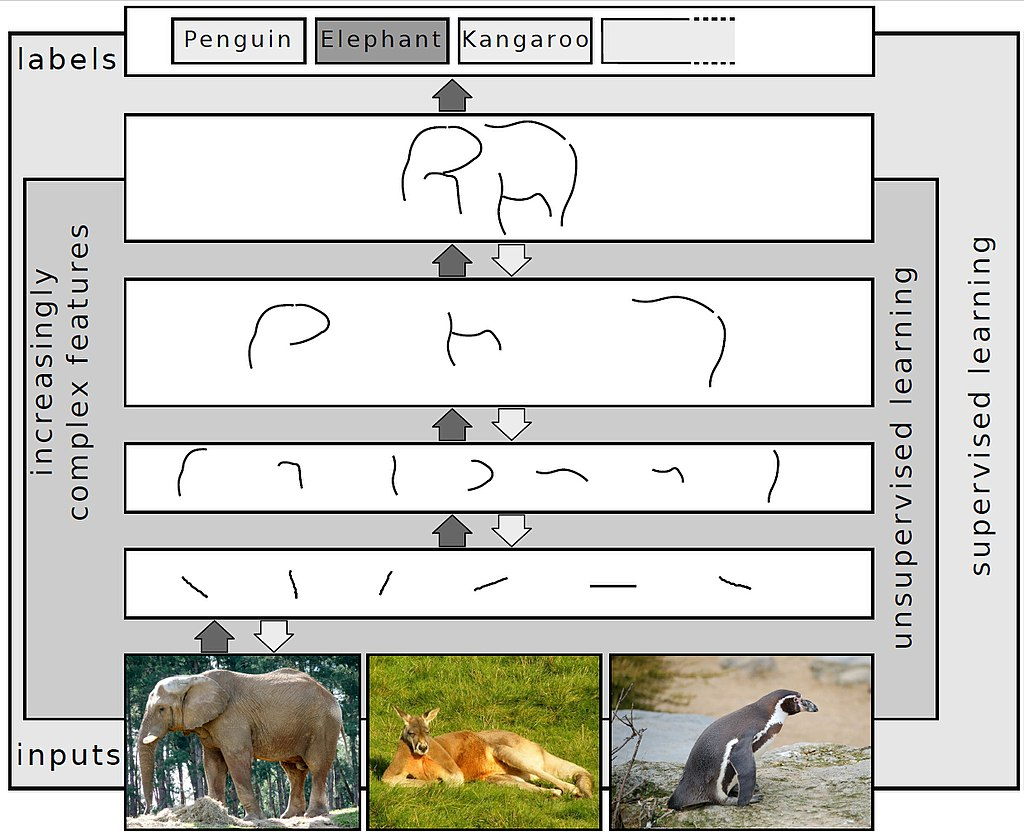
Lad os nu forstå betydningen af disse lag ved hjælp af et enkelt eksempel. Forestil dig, at du vil have det neurale netværk til at genkende et dyr på et foto. Til det formål har du udviklet et neuralt netværk, der består af seks lag, som fungerer på følgende måde:
- Inputlaget, som modtager små segmenter af billedet af dyret og sender dem videre til det første skjulte lag.
- Det første skjulte lag forsøger at finde grundlæggende former (f.eks. lige linjer) i hvert segment og sender disse oplysninger videre til det andet lag.
- Det andet lag kombinerer derefter nogle af disse linjer til grundlæggende geometriske former (f.eks. cirkler, halvcirkler osv.) og sender dem videre til det tredje lag.
- Det tredje lag skaber derefter mere komplekse former ud fra disse geometriske former.
- Det fjerde lag kombinerer alle de tidligere skabte former og danner omridset af et dyr.
- Outputlaget angiver til sidst den type dyr, som det har genkendt ud fra formen.
Sådan vil det se ud visuelt.
Når du ser på processen ovenfor, undrer du dig måske over, hvordan AI-ingeniører får disse lag til at genkende former og gætte dyret på billedet, ikke? Det gør de ved at “træne” det neurale netværk til at udføre sin opgave.
For at træne netværket giver AI-ingeniørerne det et sæt input sammen med de tilsvarende korrekte output. I vores tilfælde ville det være flere billeder af dyr som input og de samme billeder med den korrekte dyretype som output.
Da dit netværk har de korrekte svar, vil det løbende justere sig selv (de parametre, som hver neuron sender videre til andre), indtil dets svar minder meget om de korrekte svar, vi har angivet.
I virkeligheden vil dit netværk aldrig være 100 % nøjagtigt i sine svar, og der vil altid være en vis grad af fejl, som du skal tage højde for. Den gode nyhed er, at du faktisk ikke ønsker, at det skal være 100 % korrekt. Det eneste, du bekymrer dig om, er, at modellen er hurtigere og mere nøjagtig end et menneske.
Nu hvor vi har en forståelse af, hvordan det fungerer, kan vi gå videre til at forstå, hvordan du kan bruge maskinlæring i dine produkter.
Maskinlæring: Hvad det kan gøre, og hvad det ikke kan

Hypen omkring AI er enorm, og mange startupstiftere eller produktchefer drømmer om at tilføje AI til deres produkter. Men her er spørgsmålet til en million dollars: Har du virkelig brug for AI?
Jeg forstår godt, at betegnelsen “AI-drevet” ser godt ud i enhver produkts investorpitch og markedsføringsmateriale, men glem ikke, at det er dyrt og tidskrævende at opbygge en AI-model.
Hvis din AI-model derfor har til hensigt at løse et grundlæggende problem, som du nemt kunne have håndteret med almindelig kode, ender du med at spilde dine penge på et smart udtryk på dit websted.
For at forstå, om du har brug for en AI-model, kan vi se på de opgaver og problemer, du kan håndtere med den, og sammenligne dem med dem, du bør løse med almindelig programmering.
Have an account? Log In
Almindelige opgaver, som maskinlæringsmodeller kan håndtere for dig
ML-modeller er ikke magiske – selvom det bestemt kan virke sådan med alle de måder, du kan bruge ChatGPT på og andre nye store sprogmodeller. Selvom vi ser en stigning i avancerede AI-værktøjer, kan mange produkter drage fordel af enklere ML-modeller.
Den funktion, som disse modeller udfører, falder normalt ind under disse fire kategorier.
Klassifikation
Som navnet antyder, kan disse modeller genkende de oplysninger, du giver dem, og klassificere dem eller tildele oplysningerne en etiket. Eksemplet med at genkende dyr ud fra billedet, som vi tidligere har gennemgået, er et typisk tilfælde af AI-klassifikation.
Området for AI-klassifikation opdeles igen i fire typer:
Binær klassifikation: Denne model giver dig et ja eller et nej. Almindelige anvendelser er detektorer for uønsket e-mail (isSpam = true eller false), diagnosticering af brystkræft (risikofyldt eller ikke risikofyldt) osv.
Ubalanceret klassifikation: Disse modeller opdeler data i to grupper – et normalt flertal og et unormalt mindretal. Et eksempel på dette er afsløring af svig i toldangivelser ved landegrænser.
AI-modellen undersøger dokumenterne og giver hver toldangivelse et grønt (alt er i orden), gult (dokumenterne skal kontrolleres) eller rødt (varerne skal kontrolleres) flag, afhængigt af hvor “normale” dokumenterne ser ud sammenlignet med andre.
Multiklasseklassifikation: I dette tilfælde vælger modellen en af de mange foruddefinerede værdier. Algoritmer til optisk tegngenkendelse (dem, der udtrækker tekst fra et billede) hører til denne type.
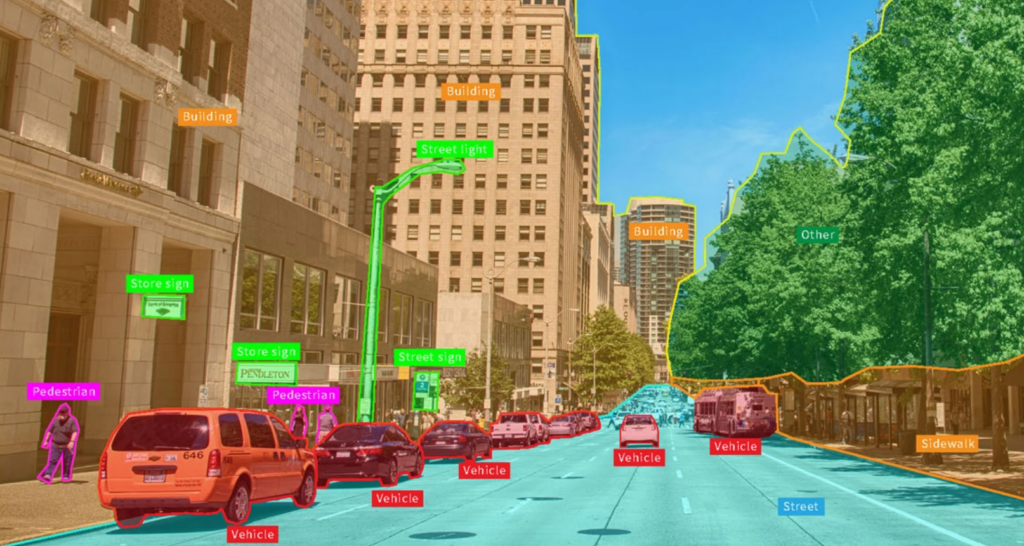
Multimærkeklassifikation: I modsætning til den foregående type tildeler disse modeller flere mærkater til det samme stykke data. Mange algoritmer inden for computervision falder ind under denne kategori, da de analyserer billedet eller videoen og identificerer flere objekter i det. Sådan ser multimærkeklassifikation ud for en selvkørende bil.
Andre anvendelser af denne teknologi omfatter udtræk af nyttige oplysninger fra teksten (f.eks. holdninger til dit brand fra tweets) eller identifikation af diskussionsemner i en podcast.
Regression
Denne klasse af AI-modeller er i stand til at foretage forudsigelser baseret på eksisterende oplysninger. Med regressionsmodeller kan du forstå forholdet mellem flere faktorer samt forudsige fremtidige værdier baseret på tidligere værdier (også kaldet prognosealgoritmer).
Nogle af anvendelserne af regressionsalgoritmer omfatter:
- Forudsigelse af aktiekurser baseret på tidligere prisudsving.
- Forudsigelse af prisen på en bil baseret på kilometertal, produktionsår osv.
- Forslag til de bedste annoncetekster for at opnå bedre konverteringsrater.
- Identifikation af den bedste ugedag og det bedste tidspunkt til at sende e-mails for at opnå flest åbninger og klik.
Nogle af de større modeller er også i stand til at forudsige ting, der er så komplekse og kaotiske som vejret.
Klyngedannelse
Dette er en proces baseret på ikke-overvåget læring, hvor modellen registrerer ligheder i et sæt af elementer og grupperer dem efter disse ligheder. I modsætning til klassifikation ved en algoritme til klyngedannelse ikke, hvad den ser; den ved kun, at disse elementer ligner hinanden.
Nogle af anvendelsesområderne for algoritmer til klyngedannelse er:
- Opdeling af din e-mailmarketingliste i segmenter, der opfører sig ens.
- Organisering af en stor samling bøger efter emner.
- Gruppering af fotos efter de elementer, der findes på dem.
Generelt gælder det, at hvis du har et stort sæt af elementer, som du vil opdele i forskellige grupper baseret på en bestemt egenskab, er det algoritmer til klyngedannelse, du har brug for.
Syntese
Endelig har vi de algoritmer, der er i stand til at skabe indhold. Vi taler om AI-kunstnere, -forfattere og -musikere.
Anvendelsesmulighederne for denne gruppe af modeller er sandsynligvis uendelige – og modellerne (nu omtalt som store sprogmodeller eller "LLM'er") bliver bedre hver dag. Her er nogle eksempler:
- Tekstforfattere til websteder, der skaber struktur og indhold optimeret til SEO.
- Fjernelse af vandmærket fra et billede og tegning af den del af billedet, der var skjult under vandmærket.
- Oprettelse af nye billeder i et spil i stedet for at lade dit grafikkort gengive dem for at spare ressourcer.
- Generering af fotos til dine annoncer, som er fri for licensbegrænsninger.
Her er et eksempel på et digt, jeg bad GPT-4 om at skrive. (Bemærk: Jeg stillede GPT-3 det samme spørgsmål i januar, og jeg forsikrer dig om, at den er langt mere talentfuld i dag.)
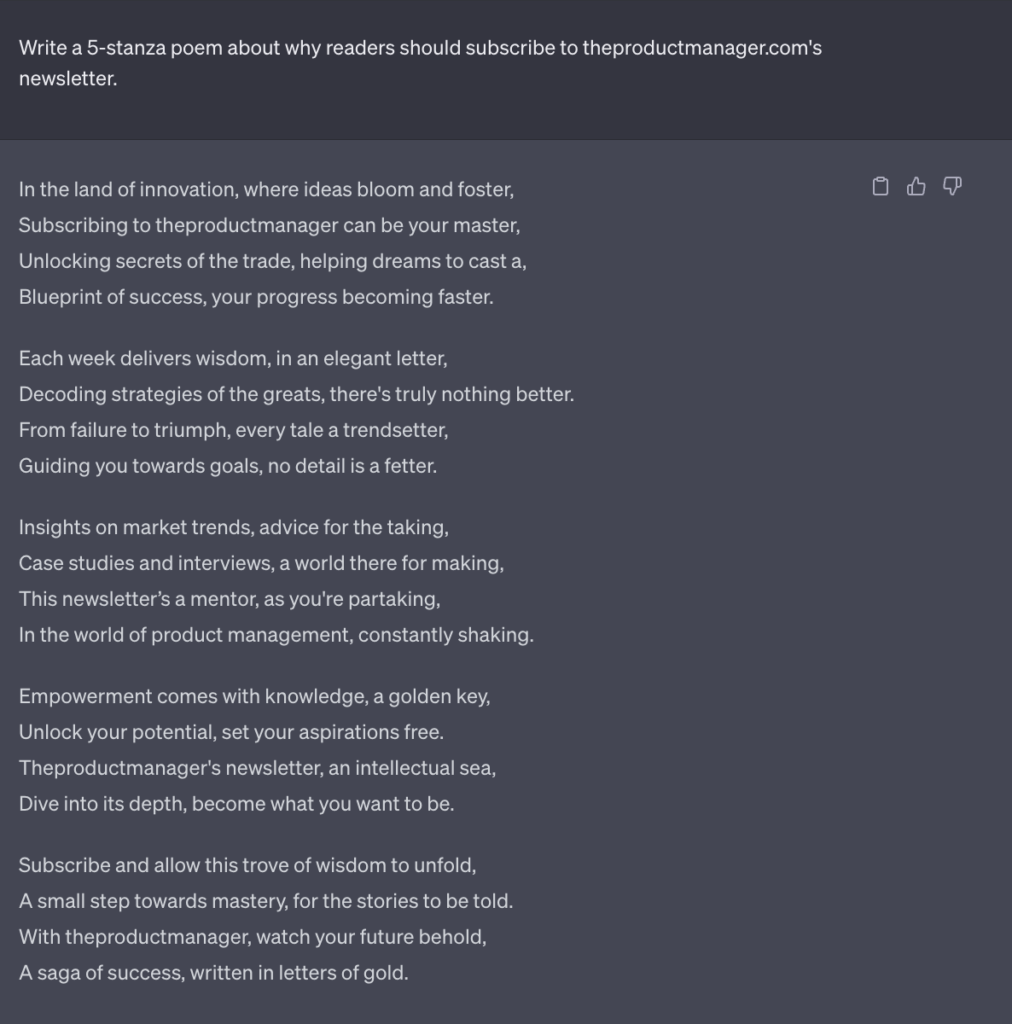
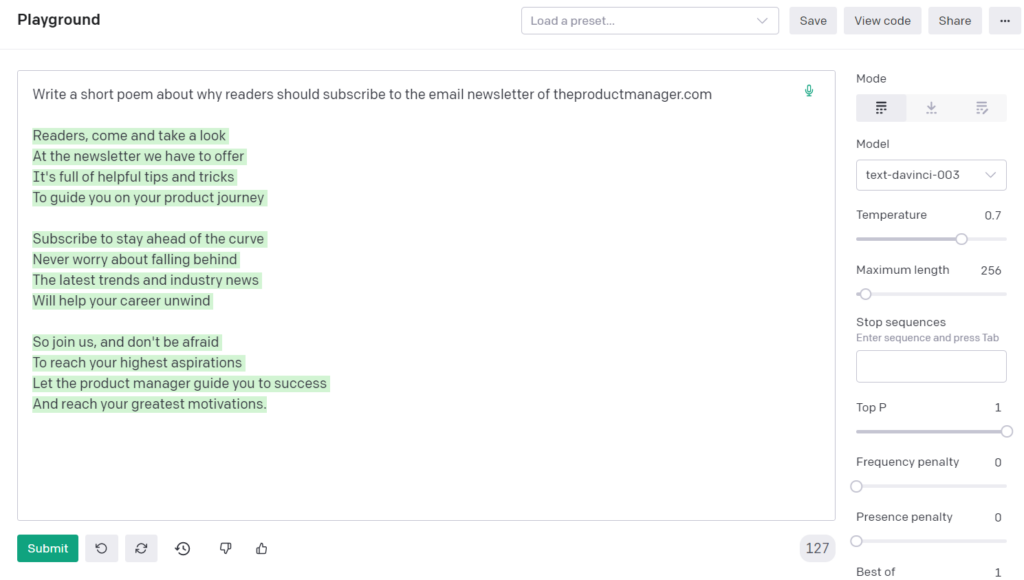
Du kan bruge naturligt sprog til at formulere en prompt, og modellen vil forstå og opfylde din anmodning baseret på den viden, den har indsamlet fra internettet.
For at opsummere er dette de mest almindelige typer af anvendelser af AI-modeller.
Det ser ud til, at der er mange ting, du kan gøre med AI, men nogle gange er det hurtigere og billigere at opgive idéen om at bygge en model og i stedet ty til enkel softwareproduktudvikling.
Opgaver, hvor du i stedet bør bruge almindelig programmering
Ikke alle problemer kræver en AI-model for at blive løst.
For at afgøre, om du kan løse det aktuelle problem uden AI, kan du spørge dig selv, om der findes et deterministisk og tydeligt sæt regler eller handlinger, som du kan følge for at løse det.
- Hvis svaret er ja, kan du bruge almindelig kode (når alt kommer til alt, er kode blot et sæt tydelige regler og kommandoer til din computer). Du behøver for eksempel ikke AI for at afgøre, om den fil, dine brugere har uploadet, er et Excel-regneark, da XLSX-filer har en fast struktur, som du kan kontrollere.
- Når du ikke kan pege på disse tydelige regler, bliver du nødt til at stole på AI-modeller til at håndtere opgaven for dig. Det oplagte eksempel her er billedgenkendelse. Der findes ikke et pålideligt sæt regler, som kan fortælle dig, om den røde ting på billedet er en bil af et bestemt mærke.
For at gøre dette begreb endnu tydeligere kan vi se på flere problemer, som du kan løse uden AI.
At finde den korteste rute fra punkt A til punkt B på kortet. Dette er et velkendt problem inden for matematik, og der findes mange deterministiske metoder (f.eks. Dijkstras algoritme), som kan løse det med almindelig kode.
At kontrollere, om der er trafikpropper på kortet. Denne opgave har en smart løsning. Google vil for eksempel hente GPS-positionsdata i realtid fra alle smartphones (hvor denne funktion er aktiveret) og kontrollere, om der står mange telefoner stille på vejen. Hvis det er tilfældet, må der være en trafikprop der.
Bemærk: Selvom du kan bruge AI her til at forudsige en trafikprop på en vej, hvor der er meget få smartphones, eller hvor positionerne er spredt.
At beregne omtaler af et brand på sociale medier. Hvis du vil finde antallet af omtaler af dit brand på sociale medieplatforme, skal du blot bruge et scrapingværktøj, der læser søgeresultater fra sociale medier og tæller dem.
Bemærk: En AI-model ville her være nyttig til at forudsige antallet af omtaler baseret på scraping af en lille del af resultaterne (i stedet for hele listen med søgeresultater) – så du sparer beregningskraft og ressourcer.
For at opsummere er AI-modeller ganske kompetente, når det gælder de opgaver, de kan udføre, men nogle gange er det nemmere at skrive kode i stedet.
Nu hvor du har fået en forståelse af, hvordan du kan bruge kunstig intelligens i dine produkter, vil jeg gå videre med at dele et par tips om arbejde med AI-modeller.
6 tips til produktchefer, der arbejder med maskinlæring
Gennem min karriere med arbejde på maskinlæringsprodukter har jeg begået mange fejl, som har resulteret i spild af tid og penge. For at sikre, at du som ML-produktchef ikke gentager disse fejl, får du her nogle nyttige tips, du bør overveje.
Kvaliteten af data vil afgøre, om dine modeller lykkes eller mislykkes
ML-ingeniørteams og dataforskere bruger gerne udtrykket “skrald ind – skrald ud.” Det betyder, at modellens kvalitet vil afhænge direkte af kvaliteten af de datasæt, du bruger til at træne den.
For at forklare, hvad jeg mener med dårlige data, vil jeg gennemgå nogle af de aspekter, der afgør deres kvalitet:
Dårlige annoteringer: Annotering er processen, hvor man manuelt mærker nye data for at bruge dem som “korrekte resultater” i træningen af din model. Annotatorer til en model, der genkender dyr, vil for eksempel fremhæve dyret på billedet og mærke det med dets navn. Hvis du mærker elefanter som “pingviner”, vil din model også gøre det efter træningen.
Manglende mangfoldighed: Dine modeller fungerer kun godt, hvis dataene fra den virkelige verden ligner de data, de er blevet trænet på. Hvis du har et system til registrering af nummerplader, der kun har lært at læse amerikanske nummerplader, vil det mislykkes fuldstændigt, når det ser en bil med EU-nummerplader.
Bias i data: Har du nogensinde hørt om racistisk AI? Google har for nylig undskyldt over for det afroamerikanske samfund, fordi deres computervisionsalgoritme gjorde dette:
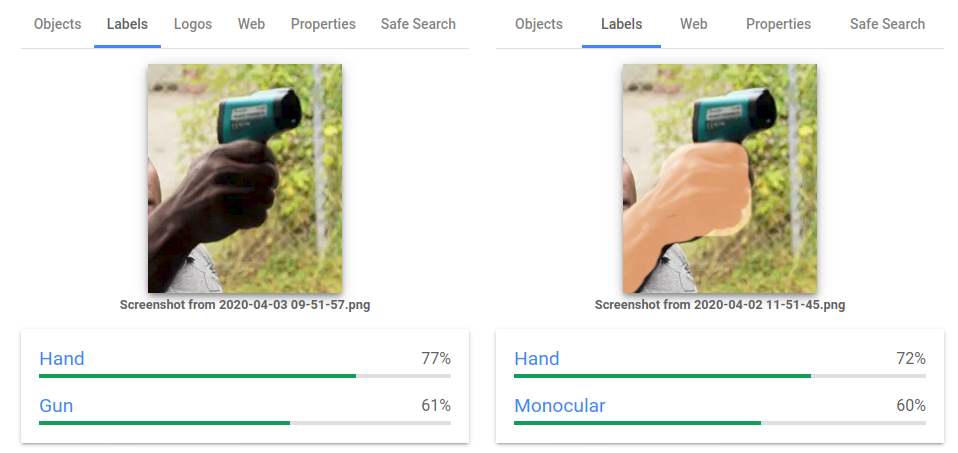
Der findes også adskillige tilfælde, hvor politiets AI-modeller målretter sig mod minoriteter.
Årsagen er forudindtagede data. Disse AI-systemer hos politiet havde brugt databasen fra en politistation, der var berygtet for at være racemæssigt forudindtaget. Derfor indeholdt den mange data om anholdelser af minoriteter, hvilket fik AI-modellen til at målrette sig mod dem.
Sørg derfor for, at de data, du bruger, ikke indeholder forudindtagethed, som potentielt kan føre til respektløshed, krænkelse eller noget værre.
Udvikl funktioner, der hjælper dig med at genlære dine modeller
At bygge modeller er kun halvdelen af arbejdet – du skal også hele tiden forbedre dem ved at tilføje nye funktioner eller ganske enkelt give dem friske data, som de kan genlæres på.
Det kan være en udfordring at finde data til genindlæring, som er relevante for dit ML-produkt. Overvej derfor at tilføje funktioner, der gør det muligt at hente disse data fra selve produktet.
Her er to tilgange til feedbacksløjfer, som jeg har prøvet (og som fungerede godt):
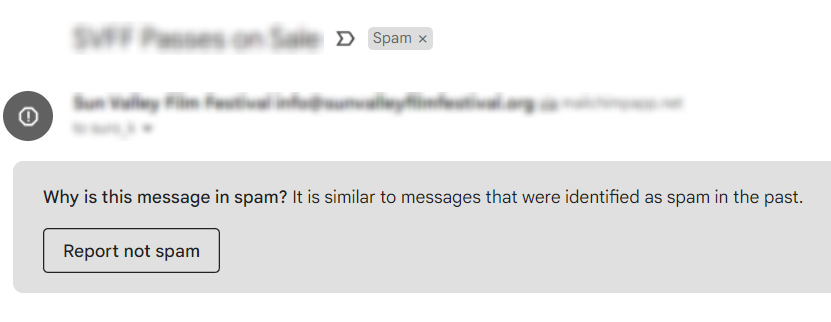
Bed om feedback på AI-resultaterne: Hvis du registrerer spam i e-mails, kan du tilføje en »ikke spam«-knap, så dine brugere kan fjerne e-mailen fra spam. Som følge af denne handling vil de også »annotere« e-mailen som spamfri, og du kan bruge den til at genindlære din model.
Bemærk: Ja, det er præcis det, knappen »Rapportér ikke som spam« gør i Gmail.
Giv brugeren mulighed for at finjustere din model på baggrund af sine data: Det er en fordel for begge parter. Dine brugere får en model, der fungerer bedre, fordi du har genindlært den på deres specifikke data, mens du får ekstra data til at øge mangfoldigheden i din model.
Brug færdige løsninger i stedet for at bygge dine egne, hvis du kan
Du behøver ikke genopfinde AI-hjulet. Der findes masser af færdige modeller, som du kan købe eller leje. Det er især relevant, hvis du forsøger at løse et problem, der er relativt almindeligt (f.eks. at identificere nøgenbilleder i din app til sociale medier).
Du kan finde færdige modeller på platforme som Modelplace og RapidAPI Hub.

En simpel søgning efter en model til logoregistrering gav os 9 færdige løsninger, som vi kan integrere via API.
Brug open source-AI-modeller, og bidrag til dem
Kunstig intelligens har et betydeligt open source-fællesskab. Du kan trække på det for enten at finde færdige modeller eller nyttige værktøjer, der kan hjælpe dig med at bygge dine modeller.
Du kan se denne liste på GitHub over nogle af de bedste open source-projekter og -initiativer inden for maskinlæring. Listen er ret mangfoldig og omfatter:
- Modeller med forskellige niveauer af forklarbarhed (hvor godt du kan forklare, hvordan din model fungerer), skrevet i Python og C af giganter som IBM og Amazon.
- Træningsdata til dine modeller.
- Værktøjer til dataanalyse, sporing af nøgletal, anomalidetektion og meget mere.
Bemærk: Hvis du har foretaget forbedringer af disse modeller, så opret venligst en pull request, og del dit arbejde med open source-fællesskabet og dets interessenter. Open source handler om fantastiske mennesker, der gør fantastiske ting og deler dem med andre.
More Articles
- 15 bedste blogs om produktledelse, du bør følge i 2026
- Intensivkursus i ledelse: 12 kurser i produktledelse, der løfter dig’
- Værktøjer til produktstyring: 12 typer & sådan vælger du
- 7 bøger om produktanalyse til bedre beslutninger i 2026
- 18 bedste kurser i produktmarkedsføring til opkvalificering i 2026
AI-modeller tager tid at bygge
Metoderne fra Agile og MVP fungerer ikke altid med ML-systemer. Du kan ikke altid bygge en lille model og derefter tilføje nye funktioner oven på den gennem flere iterationer. Nogle gange vil en lille ændring af en model betyde, at den skal genindlæres fra bunden.
Du kan endda komme ud for, at en optimering af din model på 10 % betyder, at du må kassere den gamle model og skabe en ny maskinlæringsalgoritme.
En anden ting, man bør overveje, er det specifikke arbejde, som data science-professionelle eller tværfunktionelle teams med sådanne kompetencer udfører.
Nogle gange vil de ikke kunne give dig et estimat for, hvornår de afslutter deres arbejde, fordi de bruger størstedelen af deres tid på at opfinde noget helt nyt, og de har ingen idé om, hvor lang tid udviklingsprocessen vil tage. (Et godt eksempel på dette er den skiftende tidsplan for Googles lancering af Gemini.)
Undgå drastiske ændringer i din databasestruktur
Det er en smertefuld virkelighed, som jeg har oplevet et par gange.
Hvis du bruger dine egne data til at genindlære dine modeller, bør du undgå at ændre strukturen i din database.
Dine modeller vil være bygget til at behandle data med en bestemt struktur og type, og hvis dit datateknikteam ændrer dine databaser, bliver dit ML-team nødt til at ændre dine modeller og måske endda genindlære dem fra bunden.
Læring er en løbende proces.
Kunstig intelligens har gjort verden til et bedre sted for os alle, fordi den har gjort det muligt for mange visionære stiftere og ML-produktchefer at løse problemer, der tidligere virkede umulige.
Jeg håber, at denne guide har hjulpet dig med at forstå konceptet AI i produktledelse, produktlederens rolle i denne proces samt de virkelige måder, virksomheder kan bruge AI på.
Men at bygge fantastiske nye produkter handler ikke kun om korrekt brug af AI. Der er også mange vigtige produktaspekter, som du bør mestre, herunder:
- Kunsten at bygge minimumle levedygtige produkter.
- Planlægning af dit teams arbejde på den rigtige måde med produktroadmaps.
- At finde dit PMF på en omkostningseffektiv måde osv.
Endelig kan du, som digtet i GPT-3-demoen har antydet, abonnere på vores nyhedsbrev for at få det bedste inden for produktledelse og være på forkant med udviklingen.