Yapay Zekâ, şu anda teknoloji dünyasındaki muhtemelen en popüler konu.
Yapay zekâ destekli ürünlerin milyar dolarlık girişimlere dönüştüğünü veya yüz milyonlarca dolarlık girişim sermayesi elde ettiğini görüyorsunuz. Ayrıca takip ettiğimiz ve kendilerinden bir şeyler öğrendiğimiz bu yapay zekâ destekli ürünlere liderlik eden ünlü ürün liderleri de var.
Birçok ürün yöneticisi, ya bir yapay zekâ ürününe liderlik ederek ya da mevcut ürünlerine yapay zekâ yetenekleri ekleyerek bu inanılmaz teknolojiden faydalanmak istiyor. Eğer siz de onlardan biriyseniz, bu yazı sizin için.
Birçok yapay zekâ ürünü geliştirdim ve bu teknolojiyi anlamanıza ve ondan en iyi şekilde yararlanmanıza yardımcı olmak için buradayım.
Makine Öğrenmesi Nedir?
Makine öğrenmesi, sağladığımız bilgilerden “öğrenebilen” ve bu eğitimin sonucunda belirli görev türlerini etkili bir şekilde gerçekleştirebilen algoritmalar ve yazılımlar oluşturmaya odaklanan bir disiplindir.
Terim ve alanın kendisi şaşırtıcı derecede eskidir—1959 yılına, dönemin önde gelen bilgisayar bilimcilerinden IBM'den Arthur Samuel'in bunu "Dama Oyunu Kullanılarak Makine Öğrenmesi Üzerine Bazı Çalışmalar" adlı çalışmasında ortaya attığı döneme kadar uzanır.
Ancak 60 yıllık geçmişine rağmen makine öğrenmesi, özellikle grafik işlem birimlerindeki (GPU'lar) büyük bilgi işlem gücü artışı sayesinde yalnızca son on yılda popüler hâle geldi.
Peki makine öğrenmesinin yapay zekâyla ne ilgisi var? Önce bu konuyu açıklığa kavuşturarak devam edelim.
Makine Öğrenmesi (ML) ve Yapay Zekâ (AI)
Herkes, görsellerdeki nesneleri tanıyabilen, şiirler yazabilen ve ayrıntılı istemlere etkileyici yanıtlar oluşturabilen akıllı yazılımları ifade etmek için “makine öğrenmesi” ve “yapay zekâ” terimlerini birbirinin yerine kullanıyor.
Ancak yapay zekâ, algılama ve akıl yürütme yeteneklerine sahip makinelerle ilgili daha geniş bir kavramken makine öğrenmesi, öğrenebilen yazılımlara odaklanan yapay zekânın bir alt kümesidir.
Terimlerin tanımlarını geride bıraktığımıza göre bu makinelerin nasıl öğrendiğini ve nasıl çalıştıklarının temel unsurlarını anlamaya geçelim.
Makine Öğrenmesi Nasıl Çalışır?
Makine öğrenmesini anlamak için öncelikle en yaygın biçimi olan derin öğrenme sinir ağlarını gözden geçirmeliyiz.
Sinir ağı, biyolojik bir beynin işleyişini taklit etmeye çalışan, normal kodla yazılmış bir yapıdır. İnsanlarda ve diğer canlılarda beyin, birbirine bağlı karmaşık bir nöron (sinir hücresi) ağıdır; bir hücreden gelen uyarı başka bir hücreyi etkinleştirir ve bilgi nöronlar ağı boyunca ilerler.
Biyolojiyi açıklayacak doğru kişi olduğumu düşünmüyorum (bu konuda oldukça başarısız olurdum), bu nedenle teknolojiyle sınırlı kalacağım.
Yazılımlardaki sinir ağları kabaca şöyle görünür:
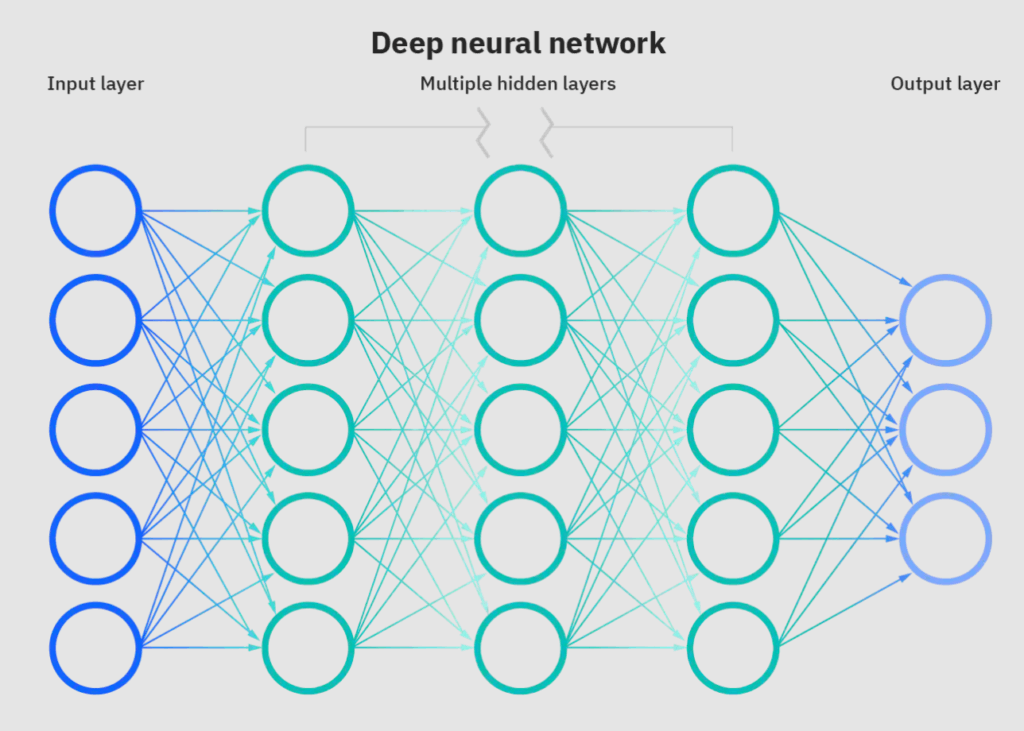
Buradaki her daire tek bir nörondur. Kodda nöron, bir tür bilgiyi alabilen, işleyebilen ve sonucu bir sonraki nörona aktarabilen basitçe bir işlevdir.
Not: bu, gerçek sürecin basitleştirilmiş hâlidir. Daha fazla ayrıntı için, bu teknolojinin ardındaki matematiksel kavramların da açıklandığı 3blue1brown YouTube kanalındaki olağanüstü Sinir Ağları video dersini izleyebilirsiniz.
Yukarıdaki görselde görebildiğimiz gibi nöronlarımız katmanlar hâlinde düzenlenmiştir. Sinir ağlarında genellikle üç tür katman bulunur:
- Dış dünyadan bilgi almaktan sorumlu olan girdi katmanı.
- Bilgiyi işleyen ve her biri bilginin tek bir yönünü ele alan gizli katmanlar.
- İşlenmiş sonucu dış dünyaya geri veren çıktı katmanı.
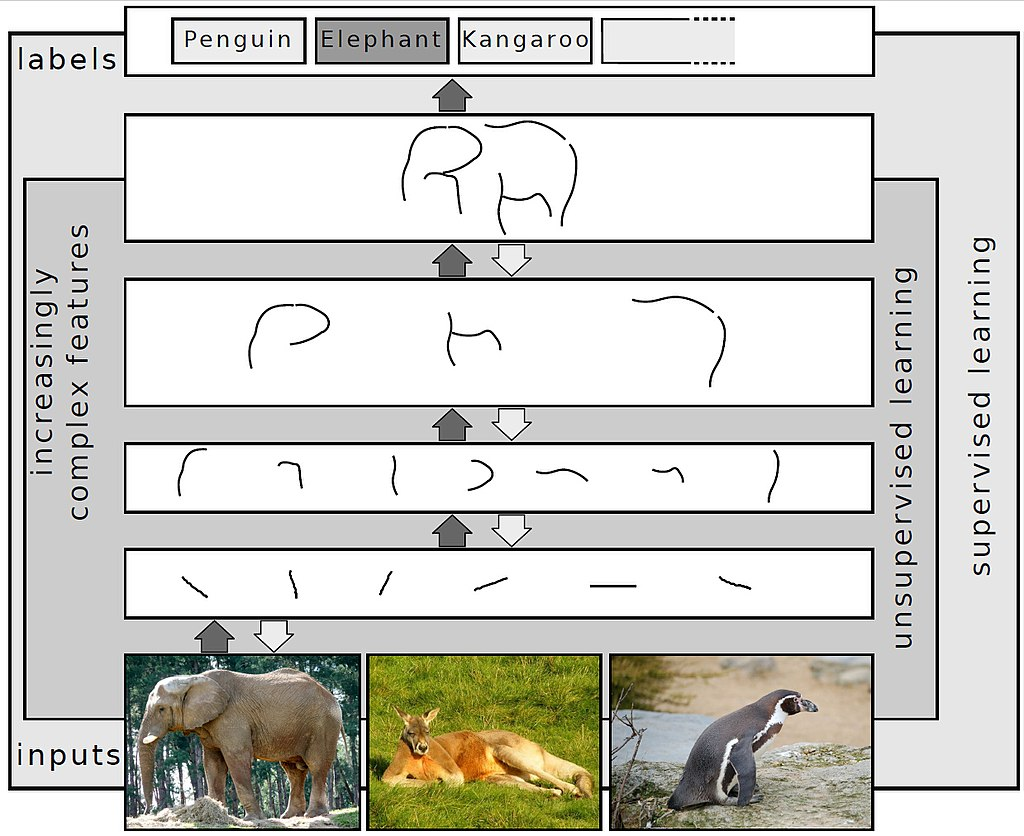
Şimdi basit bir örnekle bu katmanların anlamını anlayalım. Bir fotoğraftaki hayvanı tanıması için sinir ağını eğitmek istediğinizi düşünün. Bunun için, aşağıdaki şekilde çalışacak altı katmandan oluşan bir sinir ağı tasarladınız:
- Hayvan fotoğrafının küçük bölümlerini alacak ve ilk gizli katmana aktaracak girdi katmanı.
- İlk gizli katman, her bölümde temel şekilleri (ör. düz çizgiler) bulmaya çalışacak ve bu bilgiyi ikinci katmana aktaracak.
- İkinci katman, bu çizgilerin bazılarını temel geometrik şekillerde (ör. daireler, yarım daireler vb.) birleştirecek ve bunları üçüncü katmana aktaracak.
- Üçüncü katman, bu geometrik şekillerden daha karmaşık şekiller oluşturacak.
- Dördüncü katman, daha önce oluşturulan tüm şekilleri birleştirecek ve bir hayvanın ana hatlarını elde edecek.
- Son olarak çıktı katmanı, şekilden tanıdığı hayvanın türünü verecek.
Görsel olarak nasıl görüneceği aşağıda gösterilmiştir.
Yukarıdaki sürece baktığınızda, yapay zekâ mühendislerinin bu katmanların şekilleri tanımasını ve görseldeki hayvanı tahmin etmesini nasıl sağladığını merak ediyor olabilirsiniz, değil mi? Bunu, sinir ağını görevini yerine getirecek şekilde “eğiterek” yaparlar.
Ağı eğitmek için yapay zekâ mühendisleri, ona karşılık gelen doğru çıktılarla birlikte bir dizi girdi verir. Bizim örneğimizde girdiler, hayvanların birkaç görüntüsü; çıktılar ise bu görüntülerin doğru hayvan türüyle birlikte sunulmuş hâli olurdu.
Ağınız doğru yanıtlara sahip olduğundan, yanıtları sağladığımız doğru yanıtlara çok benzeyene kadar kendini (her nöronun diğerlerine aktardığı parametreleri) sürekli olarak ayarlayacaktır.
Gerçek hayatta ağınız yanıtlarında hiçbir zaman %100 doğru olmayacak ve her zaman göz önünde bulundurmanız gereken belirli bir hata payı olacaktır. İyi haber şu ki modelin %100 doğru olmasını gerçekten istemezsiniz. Sizin için önemli olan, modelin bir insandan daha hızlı ve daha doğru olmasıdır.
Artık nasıl çalıştığını anladığımıza göre, ürünlerinizde makine öğrenmesini nasıl kullanabileceğinizi anlamaya geçelim.
Makine Öğrenmesi: Neler Yapabilir, Neleri Yapamaz?
Yapay zekâ etrafındaki heyecan kesinlikle çok büyük ve birçok girişim kurucusu veya ürün yöneticisi ürünlerine yapay zekâ eklemeyi hayal ediyor. Ancak asıl önemli soru şu: Yapay zekâya gerçekten ihtiyacınız var mı?
“Yapay zekâ destekli” ifadesinin herhangi bir ürünün yatırım sunumunda ve pazarlama materyallerinde iyi göründüğünü anlıyorum; ancak bir yapay zekâ modeli oluşturmanın pahalı ve zaman alıcı olduğunu unutmayın.
Bu nedenle, yapay zekâ modeliniz sıradan kodlarla kolayca çözebileceğiniz temel bir sorunu çözmeyi amaçlıyorsa, sonunda paranızı web sitenizde gösterişli bir terim kullanmak için boşa harcamış olursunuz.
Bir yapay zekâ modeline olan ihtiyacınızı anlamak için, onunla ele alabileceğiniz görevleri ve sorunları tartışalım ve bunları normal kodlamayla çözmeniz gerekenlerle karşılaştıralım.
Have an account? Log In
Makine Öğrenmesi Modellerinin Sizin İçin Gerçekleştirebileceği Yaygın Görevler
ML modelleri sihir değildir—her ne kadar ChatGPT'yi kullanabileceğiniz yollar ve diğer yeni büyük dil modelleri nedeniyle kesinlikle öyle görünse de. Gelişmiş yapay zekâ araçlarında bir artış görüyor olsak da birçok ürün daha basit ML modellerinden yararlanabilir.
Bu modellerin gerçekleştirdiği işlevler genellikle şu dört kategoriden birine girer.
Sınıflandırma
Adından da anlaşılacağı üzere bu modeller, kendilerine sağladığınız bilgileri tanıyabilir ve bu bilgileri sınıflandırabilir veya onlara bir etiket atayabilir. Daha önce ele aldığımız görseldeki hayvanları tanıma örneği, yapay zekâ sınıflandırmasının tipik bir örneğidir.
Yapay zekâ sınıflandırması alanı ise dört türe ayrılır:
İkili Sınıflandırma: Bu model size Evet veya Hayır yanıtı verir. Bunun yaygın kullanım alanları arasında e-posta spam algılayıcıları (isSpam = true veya false), meme kanseri teşhisi (riskli veya risksiz) vb. bulunur.
Dengesiz Sınıflandırma: Bu modeller verileri iki gruba ayırır: normal çoğunluk ve anormal azınlık. Buna örnek olarak devlet sınırlarındaki gümrük beyannamelerinde dolandırıcılık tespiti verilebilir.
Yapay zekâ modeli, belgeleri inceleyecek ve belgelerin diğerlerine kıyasla ne kadar “normal” göründüğüne bağlı olarak her gümrük beyannamesine yeşil (işlem için uygun), sarı (belge incelemesi gerekiyor) veya kırmızı (eşya incelemesi gerekiyor) işareti verecektir.
Çok Sınıflı Sınıflandırma: Bu durumda model, önceden tanımlanmış birçok değerden birini seçer. Optik karakter tanıma algoritmaları (bir görüntüdeki metni çıkaran algoritmalar) bu türe girer.
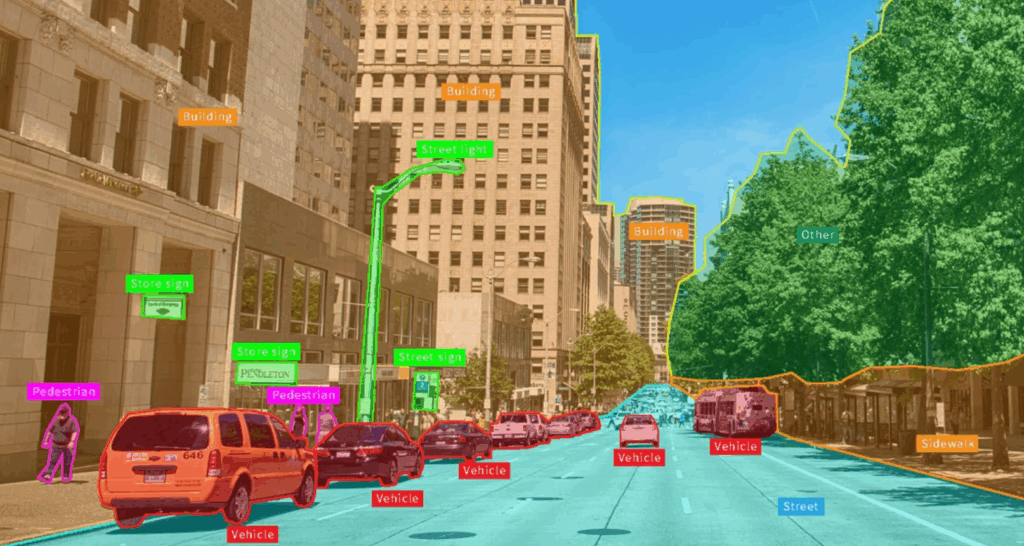
Çok Etiketli Sınıflandırma: Öncekinden farklı olarak bu modeller, aynı veri parçasına birden fazla etiket atar. Birçok bilgisayarlı görü algoritması bu kategoriye girer; çünkü görüntüye veya videoya bakarak içindeki birden fazla nesneyi tanımlarlar. Kendi kendine giden bir otomobil için çok etiketli sınıflandırma şu şekilde görünür.
Bu teknolojinin diğer uygulamaları arasında metinden faydalı bilgilerin çıkarılması (ör. Tweet'lerden markanız hakkındaki görüşler) veya bir podcast içindeki tartışma konularının belirlenmesi yer alır.
Regresyon
Bu yapay zekâ modeli sınıfı, mevcut bilgilere dayanarak tahminler yapabilir. Regresyon modelleriyle birkaç faktör arasındaki ilişkiyi anlayabilir ve geçmişteki değerlere dayanarak gelecekteki değerleri tahmin edebilirsiniz (diğer adıyla öngörü algoritmaları).
Regresyon algoritmalarının bazı kullanım alanları şunlardır:
- Geçmiş fiyat dalgalanmalarına dayanarak hisse senedi fiyatını öngörmek.
- Kilometre, üretim yılı vb. bilgilere dayanarak bir otomobilin fiyatını tahmin etmek.
- Daha iyi dönüşüm oranları için en uygun reklam metinlerini önermek.
- En fazla açılma ve tıklanma oranını elde etmek için e-postaları göndermenin en uygun gününü ve saatini bulmak.
Daha büyük modellerden bazıları, hava durumu kadar karmaşık ve kaotik şeyleri de tahmin edebilir.
Kümeleme
Bu, modelin bir öğe kümesindeki benzerlikleri tespit ettiği ve öğeleri bu benzerliğe göre gruplandırdığı, denetimsiz öğrenmeye dayalı bir süreçtir. Sınıflandırmadan farklı olarak kümeleme algoritmasının neye baktığı hakkında hiçbir fikri yoktur; bildiği tek şey bu öğelerin birbirine benzer olduğudur.
Kümeleme algoritmalarının bazı kullanım alanları şunlardır:
- E-posta pazarlama listenizi benzer davranışlar sergileyen segmentlere ayırmak.
- Geniş bir kitap koleksiyonunu konulara göre düzenlemek.
- Fotoğrafları, içlerinde bulunan öğelere göre gruplandırmak.
Genel olarak, belirli bir özelliğe dayanarak farklı gruplara ayırmak istediğiniz geniş bir öğe kümeniz varsa ihtiyacınız olan şey kümeleme algoritmalarıdır.
Sentez
Son olarak içerik oluşturabilen algoritmalara sahibiz. Yapay zekâ sanatçılarından, yazarlardan ve müzisyenlerden söz ediyoruz.
Bu model grubunun kullanım alanları muhtemelen sınırsızdır ve (artık büyük dil modelleri veya "LLM'ler" olarak adlandırılan) modeller her geçen gün daha iyi hâle geliyor. İşte bazı örnekler:
- SEO için optimize edilmiş yapı ve içerik oluşturan web sitesi metin yazarları.
- Bir görüntüdeki filigranı kaldırmak ve filigranın altında kalan görüntü bölümünü çizmek.
- Kaynak tasarrufu sağlamak için grafik kartının oluşturmasına izin vermek yerine bir oyunda yeni kareler oluşturmak.
- Reklamlarınız için lisans ücreti gerektirmeyen fotoğraflar oluşturmak.
İşte GPT-4'ten yazmasını istediğim bir şiir örneği. (Not: Ocak ayında GPT-3'e de aynı soruyu sordum ve sizi temin ederim ki bugün çok daha yetenekli.)
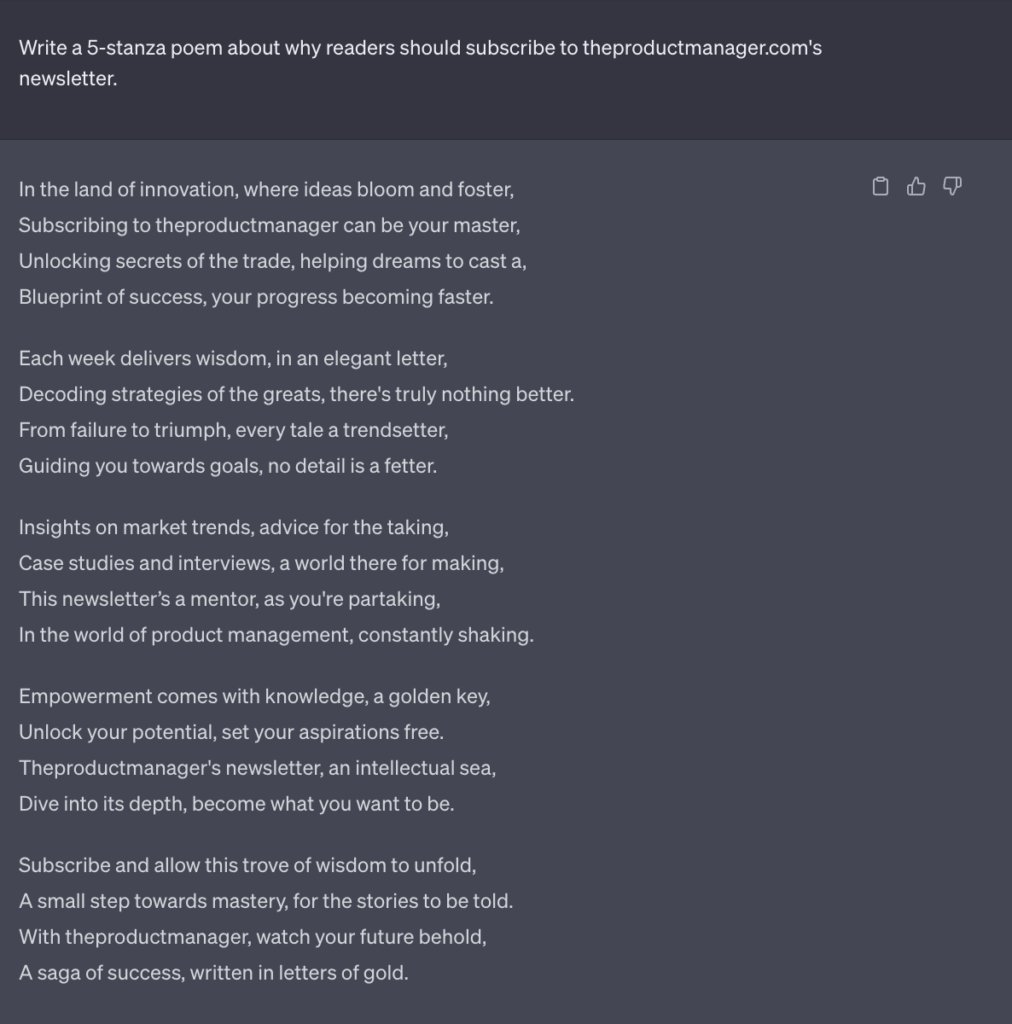
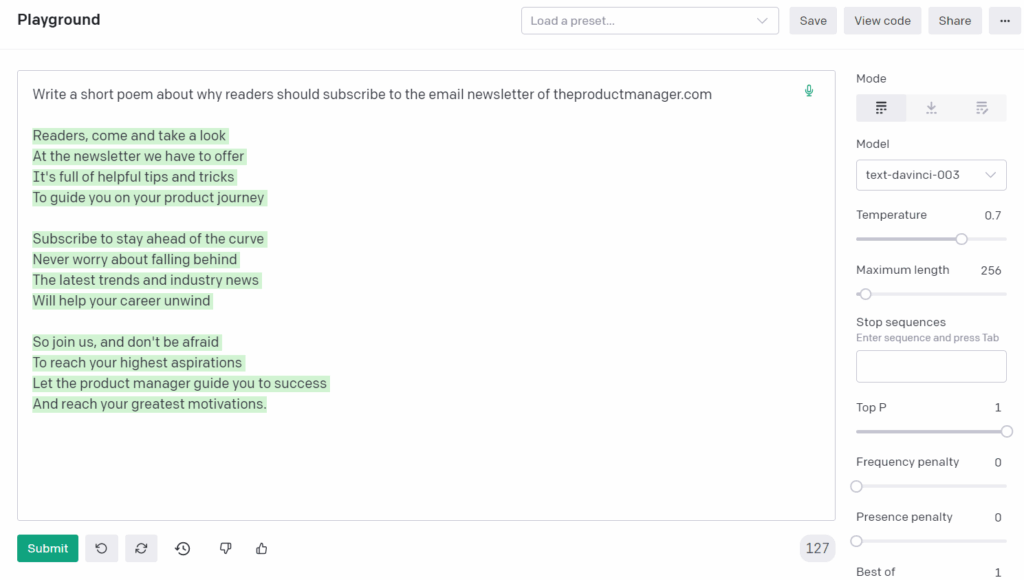
Bir istem oluşturmak için doğal dili kullanabilirsiniz; model de internetten topladığı bilgilere dayanarak isteğinizi anlayıp yerine getirir.
Özetlemek gerekirse, bunlar yapay zekâ modellerinin en yaygın uygulama türleridir.
Yapay zekâ ile yapabileceğiniz pek çok şey var gibi görünüyor; ancak bazen bir model oluşturma fikrinden vazgeçip basit bir yazılım ürünü geliştirmeye yönelmek daha hızlı ve ucuzdur.
Bunun Yerine Geleneksel Kodlama Kullanmanız Gereken Görevler
Her problemi çözmek için bir yapay zekâ modeline ihtiyaç yoktur.
Elinizdeki problemi yapay zekâ olmadan çözüp çözemeyeceğinizi belirlemek için kendinize, problemi çözmek üzere uygulayabileceğiniz deterministik ve açık bir kurallar veya eylemler dizisi olup olmadığını sorun.
- Cevap evetse, normal kod kullanabilirsiniz (sonuçta kod, bilgisayarınıza yönelik açık kurallar ve komutlar dizisinden başka bir şey değildir). Örneğin, kullanıcılarınızın yüklediği dosyanın bir Excel elektronik tablosu olup olmadığını belirlemek için yapay zekâya ihtiyacınız yoktur; XLSX dosyaları katı bir yapıya sahiptir ve bunu kontrol edebilirsiniz.
- Bu açık kuralları ortaya koyamadığınızda, bu görevi sizin yerinize gerçekleştirmesi için yapay zekâ modellerine güvenmeniz gerekir. Buradaki bariz örnek görüntü tanımadır. Görüntüdeki kırmızı şeyin belirli bir markaya ait bir araba olup olmadığını anlamanızı sağlayacak güvenilir bir kurallar dizisi yoktur.
Bu kavramı daha da sağlamlaştırmak için yapay zekâ olmadan çözebileceğiniz birkaç probleme göz atalım.
Haritada A noktasından B noktasına en kısa rotayı bulmak. Bu, matematikte iyi bilinen bir problemdir ve bunu sıradan kodlarla çözebilecek çok sayıda deterministik yaklaşım vardır (ör. Dijkstra algoritması).
Haritadaki trafik sıkışıklıklarını kontrol etmek. Bunun zekice bir çözümü vardır. Örneğin Google, tüm akıllı telefonlardan (bu özelliğin etkin olduğu telefonlardan) gerçek zamanlı GPS konum verilerini alır ve caddede hareketsiz duran çok sayıda telefon olup olmadığını kontrol eder. Böyle bir durum varsa, orada trafik sıkışıklığı olması gerekir.
Not: Bununla birlikte, akıllı telefonların çok az olduğu veya konumların dağınık bulunduğu bir caddedeki trafik sıkışıklığını tahmin etmek için burada yapay zekâ kullanabilirsiniz.
Sosyal medyada marka bahsedilmelerini hesaplamak. Markanızdan sosyal medya platformlarında kaç kez bahsedildiğini öğrenmek istiyorsanız, ihtiyacınız olan tek şey sosyal medya arama sonuçlarını okuyup bunları sayacak bir veri kazıma aracıdır.
Not: Burada bir yapay zekâ modeli, sonuçların tamamı yerine sonuçların küçük bir bölümünü veri kazıma yoluyla elde ederek bahsedilme sayısını tahmin etmek ve böylece işlem gücünden ve kaynaklardan tasarruf etmek için yararlı olabilir.
Özetlemek gerekirse, yapay zekâ modelleri gerçekleştirebildikleri görevler açısından oldukça yeteneklidir; ancak bazen bunun yerine kod yazmak daha kolaydır.
Yapay zekâyı ürünlerinizde nasıl kullanacağınızı artık anladığınıza göre, yapay zekâ modelleriyle çalışma konusunda birkaç ipucu paylaşmaya geçeyim.
Makine Öğrenimiyle Çalışan Ürün Yöneticileri İçin 6 İpucu
Makine öğrenimi ürünleriyle çalıştığım kariyerim boyunca zaman ve para kaybıyla sonuçlanan birçok hata yaptım. Sizin, yani makine öğrenimi ürün yöneticisinin, bu hataları tekrarlamamasını sağlamak için göz önünde bulundurmanız gereken bazı yararlı ipuçlarını burada bulabilirsiniz.
Verilerin Kalitesi Modellerinizin Başarısını Belirler
ML Mühendisliği ekipleri ve Veri Bilimcileri “çöp girer, çöp çıkar” terimini kullanmayı sever. Bu, modelin kalitesinin onu eğitmek için kullandığınız veri kümelerinin kalitesine doğrudan bağlı olduğu anlamına gelir.
Kötü veriden ne kastettiğimi anlamak için, verinin kalitesini belirleyen bazı yönleri ele alayım:
Kötü açıklamalar: Açıklama, yeni verileri modelinizin eğitimi için “doğru sonuçlar” olarak kullanmak üzere elle etiketleme sürecidir. Örneğin hayvanları tanıyan bir model için açıklama yapan kişiler, görüntüdeki canlıyı işaretler ve onu adıyla etiketler. Filleri “penguen” olarak etiketlerseniz modeliniz de eğitimden sonra aynısını yapar.
Çeşitlilik eksikliği: Modelleriniz ancak gerçek dünyadaki veriler, eğitildikleri verilere benziyorsa iyi çalışır. Yalnızca ABD plaka işaretlerini okumayı öğrenmiş bir plaka algılama sisteminiz varsa, AB plakalı bir araba gördüğünde sefil bir şekilde başarısız olur.
Verilerde önyargı: Irkçı yapay zekâ hakkında hiç duydunuz mu? Google kısa süre önce bilgisayarlı görü algoritması şu işlemi yaptığı için Afrika kökenli Amerikalılar topluluğundan özür diledi:
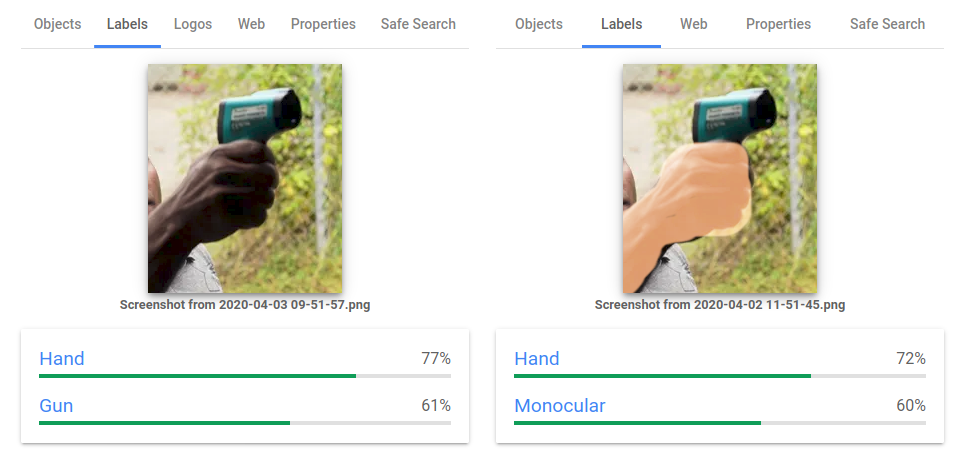
Polis yapay zekâ modellerinin azınlıkları hedef aldığı çok sayıda örnek de vardır.
Bunun arkasındaki neden önyargılı verilerdir. Bu polis yapay zekâları, ırksal açıdan önyargılı olmasıyla kötü bir üne sahip olan bir polis karakolunun veri tabanını kullanmıştı. Bu nedenle azınlıkların tutuklanmalarına ilişkin çok fazla veri vardı ve bu da yapay zekâ modelinin onları hedef almasına yol açtı.
Bu nedenle kullandığınız verilerin potansiyel olarak saygısızlığa, gücendirmeye veya daha kötüsüne yol açabilecek herhangi bir önyargı içermediğinden emin olun.
Modellerinizi Yeniden Eğitmenize Yardımcı Olacak Özellikler Oluşturun
Model oluşturmak işin yarısıdır—yeni yetenekler ekleyerek veya yeniden eğitilmesi için modele sürekli yeni veriler sağlayarak onu sürekli geliştirmeniz de gerekir.
ML ürününüzle ilgili yeniden eğitim için veri bulmak zor olabilir. Bu nedenle, bu verileri doğrudan ürünün kendisinden almanızı sağlayacak özellikler eklemeyi düşünün.
Denediğim (ve iyi sonuç veren) iki geri bildirim döngüsü yaklaşımı şunlardır:
Yapay zekâ sonuçları hakkında geri bildirim istemek: E-postalarda spam tespiti yapıyorsanız, kullanıcılarınızın e-postayı spam klasöründen çıkarması için bir “spam değil” düğmesi ekleyin. Bu işlemin sonucunda kullanıcılar o e-postayı spam içermiyor olarak “etiketlemiş” olur ve siz de bu veriyi modelinizi yeniden eğitmek için kullanabilirsiniz.
Not: Evet, Gmail'deki “Spam değil olarak bildir” düğmesi tam olarak bunu yapıyor.
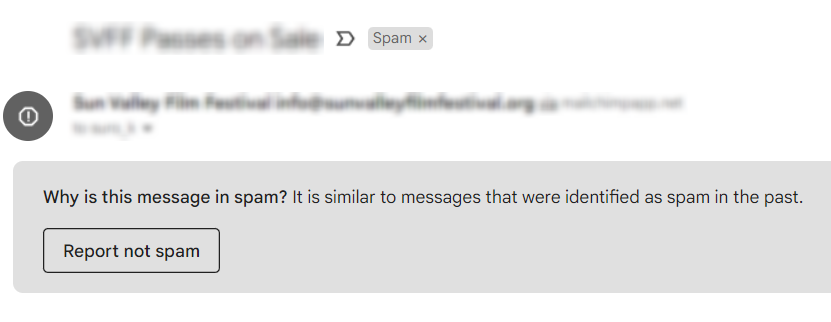
Kullanıcıya modelinizi kendi verileri üzerinde ince ayar yaparak geliştirme imkânı sunmak: Bu, her iki tarafın da kazançlı çıktığı bir durumdur. Modelinizi kullanıcılarınızın kendine özgü verileri üzerinde yeniden eğittiğiniz için kullanıcılarınız daha iyi performans gösteren bir modele sahip olurken siz de modelinizin çeşitliliğini artırmak için ek veri elde edersiniz.
Mümkünse Kendi Çözümünüzü Oluşturmak Yerine Hazır Çözümler Kullanın
Yapay zekâ çarkını yeniden icat etmek zorunda değilsiniz. Satın alabileceğiniz veya kiralayabileceğiniz çok sayıda hazır model var. Bu, özellikle görece yaygın bir sorunu çözmeye çalışıyorsanız önemlidir (örneğin, sosyal medya uygulamanızdaki çıplak görüntüleri tespit etmek).
Modelplace ve RapidAPI Hub gibi platformlarda hazır modeller bulabilirsiniz.
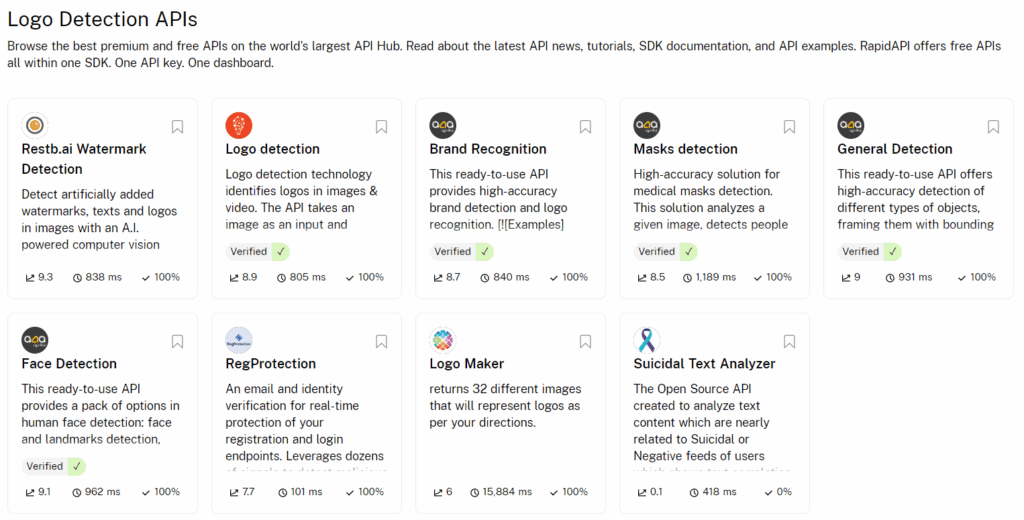
Logo tespit modeli için yaptığımız basit bir arama, API kullanarak entegre edebileceğimiz 9 hazır çözüm ortaya çıkardı.
Açık Kaynaklı Yapay Zekâ Modellerini Kullanın (ve Bunlara Katkıda Bulunun)
Yapay zekânın önemli bir açık kaynak topluluğu var. Hazır modeller veya kendi modellerinizi oluşturmanıza yardımcı olacak faydalı araçlar bulmak için bu topluluktan yararlanabilirsiniz.
Oradaki en iyi açık kaynaklı makine öğrenimi projelerinden ve girişimlerinden bazıları için GitHub'daki bu listeye göz atabilirsiniz. Bu liste oldukça çeşitlidir ve şunları içerir:
- IBM ve Amazon gibi devler tarafından Python ve C ile yazılmış, farklı açıklanabilirlik düzeylerine sahip modeller (modelinizin nasıl çalıştığını ne kadar iyi açıklayabildiğiniz).
- Modelleriniz için eğitim verileri.
- Veri analizi, temel metrik takibi, anomali tespiti ve daha fazlası için araçlar.
Not: Bu modellerde herhangi bir iyileştirme yaptıysanız lütfen bir çekme isteği açarak çalışmanızı açık kaynak topluluğu ve paydaşlarıyla paylaşın. Açık kaynak, harika insanların harika şeyler yapması ve bunları başkalarıyla paylaşmasıyla ilgilidir.
More Articles
Yapay Zekâ Modelleri Oluşturmak Zaman Alır
Çevik ve MVP metodolojileri ML sistemlerinde her zaman işe yaramaz. Her zaman küçük bir model oluşturup ardından birden fazla yinelemeyle üzerine yeni özellikler ekleyemezsiniz. Bazen bir modeli biraz değiştirmek, onu sıfırdan yeniden eğitmeniz anlamına gelir.
Hatta modelinizi %10 oranında optimize etmenin eski modeli bir kenara bırakıp yeni bir makine öğrenimi algoritması oluşturmanızı gerektirdiği bir durumla karşılaşabilirsiniz.
Dikkate almanız gereken başka bir konu da veri bilimi profesyonellerinin veya bünyesinde bu profesyonelleri barındıran çapraz işlevli ekiplerin çalışmalarının kendine özgü niteliğidir.
Bazen çalışmalarını ne zaman tamamlayacaklarına ilişkin size tahmin veremeyebilirler; çünkü zamanlarının çoğunu tamamen yeni bir şey icat etmeye harcarlar ve geliştirme sürecinin ne kadar süreceği hakkında hiçbir fikirleri yoktur. (Buna harika bir örnek, Google'ın Gemini sürümünün sürekli değişen zaman çizelgesidir.)
Veritabanı Yapınızda Köklü Değişiklikler Yapmaktan Kaçının
Bu, birkaç kez karşılaştığım can sıkıcı bir gerçekliktir.
Modellerinizi yeniden eğitmek için kendi verilerinizi kullanıyorsanız lütfen veritabanınızın yapısını değiştirmekten kaçının.
Modelleriniz belirli bir yapıya ve türdeki verileri kullanacak şekilde oluşturulur. Veri mühendisliği ekibiniz veritabanlarınızı değiştirirse ML ekibiniz modellerinizi değiştirmek ve hatta bunları sıfırdan yeniden eğitmek zorunda kalır.
Öğrenme devam eden bir süreçtir.
Yapay zekâ, geçmişte imkânsız görünen sorunları birçok vizyoner kurucunun ve ML ürün yöneticisinin çözmesini sağladığı için dünyayı hepimiz açısından daha iyi bir yer hâline getirdi.
Umarım bu rehber, ürün yönetiminde yapay zekâ kavramını, ürün yöneticisinin bu süreçteki rolünü ve işletmelerin yapay zekâyı kullanabileceği gerçek hayattaki yöntemleri anlamanıza yardımcı olmuştur.
Ancak harika yeni ürünler geliştirmek yalnızca yapay zekânın doğru kullanımıyla ilgili değildir. Ustalaşmanız gereken birçok önemli ürün unsuru da vardır. Bunlar arasında şunlar yer alır:
- Minimum Uygulanabilir Ürünler geliştirme sanatı.
- Ekibinizin çalışmalarını Ürün Yol Haritaları ile doğru şekilde planlamak.
- PMF'nizi uygun maliyetli bir şekilde bulmak vb.
Son olarak, GPT-3 demosundaki şiirin de önerdiği gibi, ürün yönetimiyle ilgili en iyi içeriklere ulaşmak ve gelişmelerin önünde kalmak için bültenimize abone olabilirsiniz.