
Maskininlärning för produktchefer: En viktig intensivkurs

Artificiell intelligens är förmodligen det hetaste ämnet inom teknikvärlden just nu.
AI-drivna produkter blir enhörningsföretag eller säkrar hundratals miljoner i riskkapital. Det finns också kända produktledare som leder dessa AI-drivna produkter och som vi följer och lär oss av.
Många produktchefer där ute vill dra nytta av denna fantastiska teknik genom att antingen leda en AI-produkt eller lägga till AI-funktioner i sina befintliga produkter. Om du är en av dem är den här till dig.
Jag har utvecklat flera AI-produkter, och jag är här för att hjälpa dig att förstå denna teknik och få ut så mycket som möjligt av den.
Vad är maskininlärning?
Maskininlärning är ett område som fokuserar på att skapa algoritmer och programvara som kan ”lära sig” av den information vi tillhandahåller och som till följd av denna träning effektivt kan utföra specifika typer av uppgifter.
Termen och själva området är förvånansvärt gamla – de går tillbaka till 1959, då Arthur Samuel från IBM (en av den tidens framstående datavetare) myntade den i sitt arbete "Några studier av maskininlärning med hjälp av spelet dam."
Trots sin 60-åriga historia har maskininlärning dock blivit populärt först under det senaste årtiondet, tack vare den enorma ökningen av beräkningskraft, särskilt i GPU:er.
Men vad har maskininlärning att göra med artificiell intelligens? Låt oss gå vidare genom att reda ut det.
Maskininlärning (ML) kontra artificiell intelligens (AI)
Alla använder termerna ”maskininlärning” och ”artificiell intelligens” omväxlande för att syfta på smart programvara som kan känna igen objekt i bilder, skriva dikter och generera imponerande svar på detaljerade uppmaningar.
Artificiell intelligens är dock det bredare konceptet med maskiner som har förmåga till perception och slutledning, medan maskininlärning är en delmängd av AI som fokuserar på programvara som kan lära sig.
När vi nu har gått igenom termdefinitionerna kan vi gå vidare till att förstå hur dessa maskiner lär sig och grunderna i hur de fungerar.
Så fungerar maskininlärning

För att förstå maskininlärning bör vi först gå igenom dess vanligaste form – neurala nätverk för djupinlärning.
Ett neuralt nätverk är en struktur skriven i vanlig kod som försöker efterlikna hur en biologisk hjärna fungerar. Hos människor och andra levande varelser är hjärnan ett komplext nätverk av neuroner (nervceller) som är sammankopplade med varandra, där en impuls från en cell aktiverar en annan och informationen färdas längs nätverket av neuroner.
Jag tror inte att jag är rätt person att förklara biologi (eftersom jag skulle misslyckas totalt med det), så jag håller mig till tekniken.
Neurala nätverk i programvara ser ut ungefär så här:
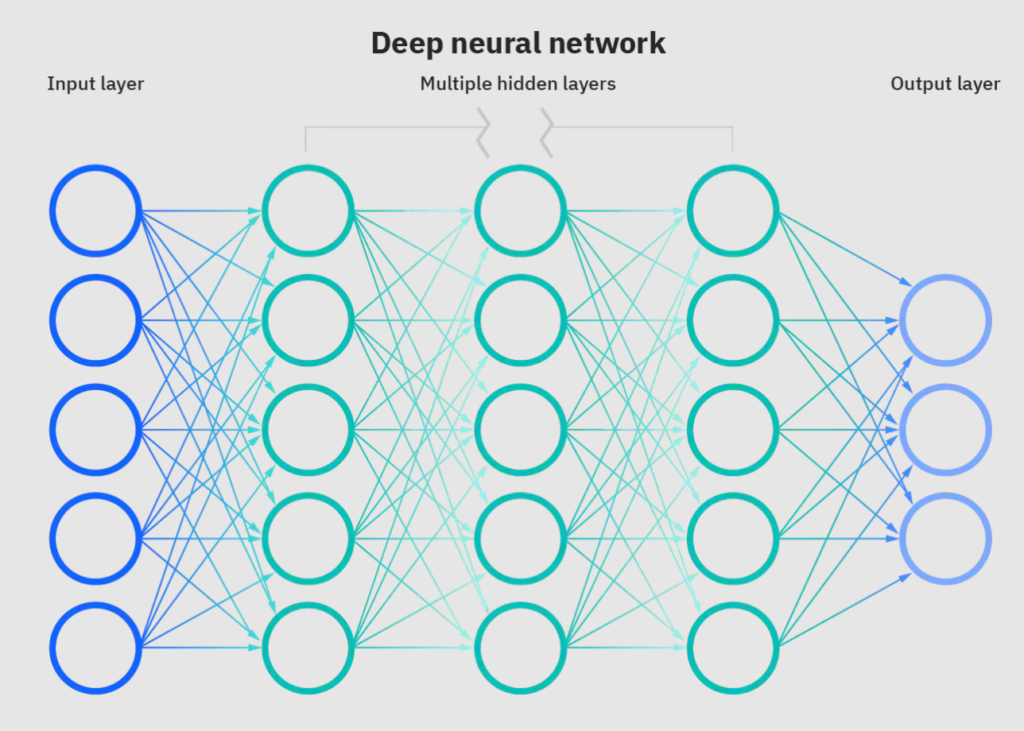
Varje cirkel här är en enskild neuron. I kod är en neuron helt enkelt en funktion som kan ta emot någon form av information, bearbeta den och skicka ett resultat vidare till nästa neuron.
Obs: detta är en förenkling av den verkliga processen. För mer information kan du titta på den utmärkta videolektionen om neurala nätverk på YouTube-kanalen 3blue1brown, där de också förklarar de matematiska begreppen bakom denna teknik.
Som vi kan se i bilden ovan är våra neuroner organiserade i lager. Neurala nätverk har vanligtvis tre typer av lager:
- Indatalagret, som ansvarar för att ta emot information från omvärlden.
- De dolda lagren bearbetar denna information, där varje lager bearbetar en enskild aspekt av den.
- Utlagret skickar tillbaka det bearbetade resultatet till omvärlden.
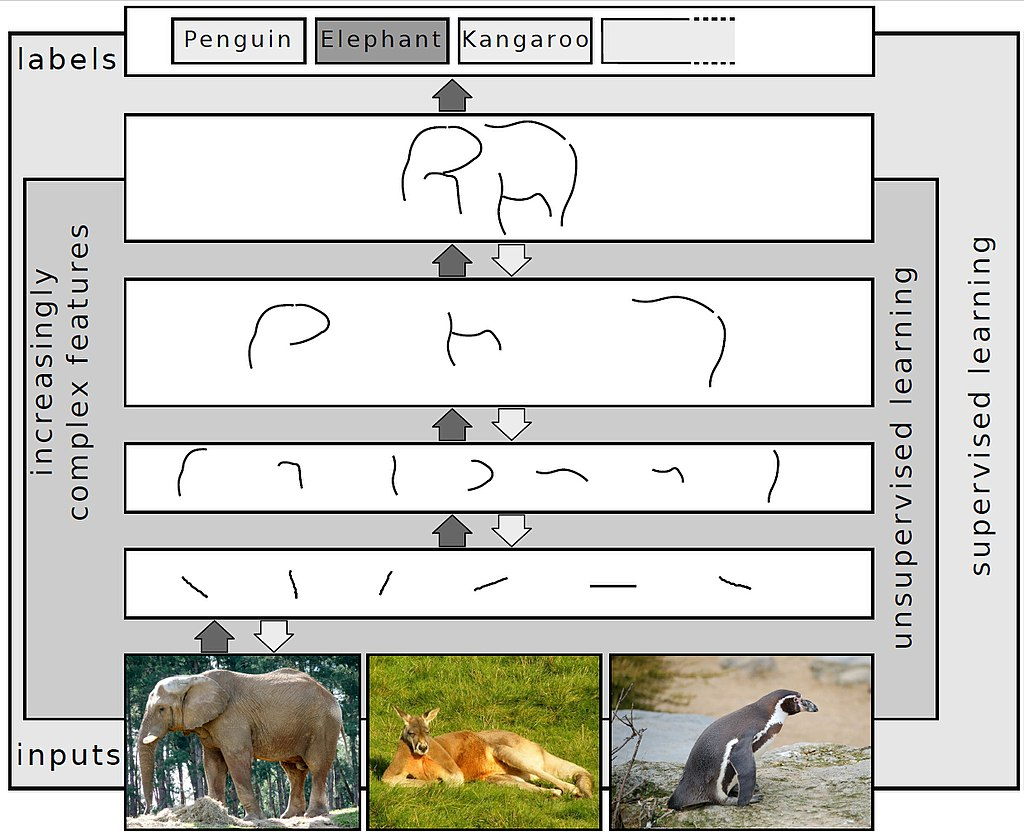
Låt oss nu förstå innebörden av dessa lager med hjälp av ett enkelt exempel. Föreställ dig att du vill att det neurala nätverket ska känna igen ett djur på ett foto. För detta har du utformat ett neuralt nätverk som består av sex lager och som fungerar på följande sätt:
- Indatalagret tar emot små delar av bilden på djuret och skickar dem till det första dolda lagret.
- Det första dolda lagret försöker hitta grundläggande former (t.ex. raka linjer) i varje del och skickar den informationen till det andra lagret.
- Det andra lagret kombinerar sedan några av dessa linjer till grundläggande geometriska former (t.ex. cirklar, halvcirklar osv.) och skickar dem till det tredje lagret.
- Det tredje lagret skapar sedan mer komplexa former utifrån dessa geometriska former.
- Det fjärde lagret kombinerar alla former som skapats tidigare och får fram konturerna av ett djur.
- Utlagret anger slutligen vilken typ av djur det har identifierat utifrån formen.
Så här kommer det att se ut visuellt.
När du tittar på processen ovan kanske du undrar hur AI-ingenjörer får dessa lager att känna igen former och gissa vilket djur som finns på bilden. Det gör de genom att ”träna” det neurala nätverket att utföra sin uppgift.
För att träna nätverket ger AI-ingenjörerna det en uppsättning indata tillsammans med motsvarande korrekta utdata. I vårt fall skulle det vara flera bilder av djur som indata och samma bilder med rätt djurtyp som utdata.
Eftersom nätverket har de korrekta svaren kommer det kontinuerligt att justera sig självt (de parametrar som varje neuron skickar till andra) tills dess svar liknar de korrekta svaren som vi har angett mycket väl.
I verkligheten kommer nätverket aldrig att vara 100 % träffsäkert i sina svar, och det kommer alltid att finnas en viss grad av fel som du måste ta hänsyn till. Den goda nyheten är att du egentligen inte vill att det ska vara 100 % korrekt. Det enda du bryr dig om är att modellen är snabbare och mer träffsäker än en människa.
Nu när vi förstår hur det fungerar går vi vidare till att förstå hur du kan använda maskininlärning i dina produkter.
Maskininlärning: Vad det kan göra och vad det inte kan göra

Hajpen kring AI är enorm och många startupgrundare eller produktchefer drömmer om att lägga till AI i sina produkter. Men här är frågan värd en miljon: behöver du verkligen AI?
Jag förstår att termen ”AI-drivet” ser bra ut i investerarpresentationen och marknadsföringsmaterialet för vilken produkt som helst, men glöm inte att det är dyrt och tidskrävande att bygga en AI-modell.
Om din AI-modell alltså är tänkt att lösa ett grundläggande problem som du enkelt hade kunnat hantera med vanlig kod, kommer du att slösa dina pengar på en flashig term på din webbplats.
För att förstå om du behöver en AI-modell ska vi diskutera vilka uppgifter och problem du kan hantera med den och jämföra dem med sådana som du bör lösa med vanlig programmering.
Vanliga uppgifter som maskininlärningsmodeller kan hantera åt dig
ML-modeller är inte magiska – även om det, med tanke på alla sätt du kan använda ChatGPT på och andra nya stora språkmodeller, verkligen kan verka så. Även om vi ser en ökning av avancerade AI-verktyg kan många produkter dra nytta av enklare ML-modeller.
Den funktion som dessa modeller utför faller vanligtvis inom någon av följande fyra kategorier.
Klassificering
Som namnet antyder kan dessa modeller känna igen informationen du tillhandahåller och klassificera den eller tilldela informationen en etikett. Exemplet med att känna igen djur från bilden som vi diskuterade tidigare är ett typiskt fall av AI-klassificering.
AI-klassificering delas i sin tur upp i fyra typer:
Binär klassificering: Den här modellen ger dig ett ja eller ett nej. Vanliga användningsområden är detektorer för skräppost i e-post (isSpam = true eller false), diagnos av bröstcancer (riskfyllt eller inte riskfyllt) osv.
Obalanserad klassificering: Dessa modeller delar upp data i två grupper – en normal majoritet och en onormal minoritet. Ett exempel på detta är upptäckt av bedrägerier i tulldeklarationer vid nationsgränser.
AI-modellen granskar dokumenten och ger varje tulldeklaration en grön (kan godkännas), gul (dokumenten behöver granskas) eller röd (varorna behöver granskas) flagga, beroende på hur ”normala” dokumenten ser ut jämfört med andra.
Multiklassificering: I det här fallet väljer modellen ett av många fördefinierade värden. Algoritmer för optisk teckenigenkänning (de som extraherar text från en bild) hör till den här typen.
Multietikettklassificering: Till skillnad från den föregående typen tilldelar dessa modeller flera etiketter till samma datamängd. Många datorseendealgoritmer hör till den här kategorin eftersom de analyserar bilden eller videon och identifierar flera objekt i den. Så här ser multietikettklassificering ut för en självkörande bil.
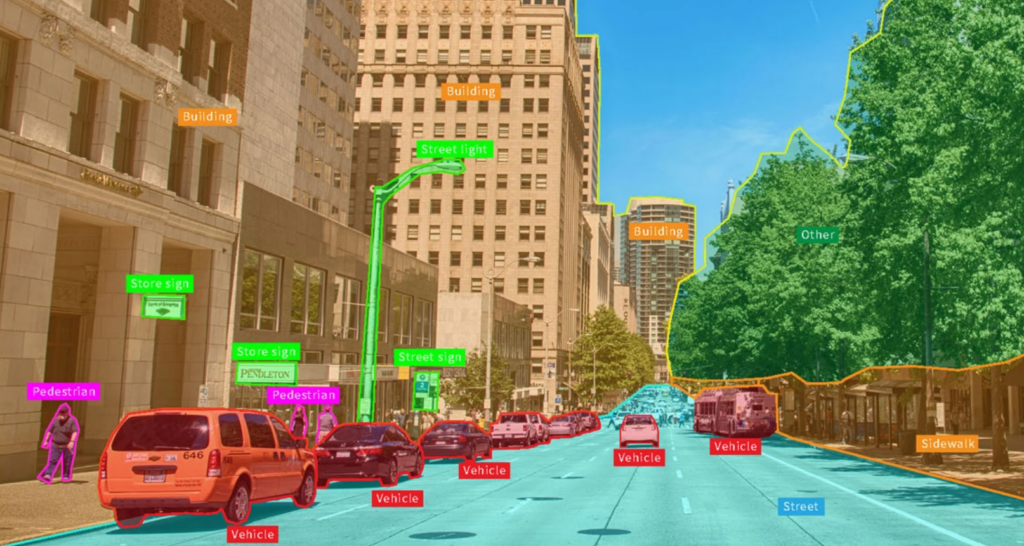
Andra tillämpningar av den här tekniken omfattar att extrahera användbar information från text (till exempel åsikter om ditt varumärke från inlägg på Twitter) eller att identifiera diskussionsämnen i en podcast.
Regression
Den här typen av AI-modeller kan göra förutsägelser baserat på befintlig information. Med regressionsmodeller kan du förstå sambandet mellan flera faktorer samt förutsäga framtida värden utifrån tidigare värden (även kallat prognostiseringsalgoritmer).
Några användningsområden för regressionsalgoritmer är:
- Prognostisera aktiekursen baserat på tidigare prisfluktuationer.
- Förutsäga priset på en bil baserat på körsträcka, tillverkningsår och så vidare.
- Föreslå de bästa annonstexterna för bättre konverteringsgrad.
- Hitta den bästa veckodagen och tiden för att skicka e-post så att du får flest öppningar och klick.
Några av de större modellerna kan också förutsäga saker som är lika komplexa och kaotiska som vädret.
Klustring
Det här är en process baserad på oövervakad inlärning där modellen upptäcker likheter i en uppsättning objekt och grupperar dem utifrån dessa likheter. Till skillnad från klassificering vet en klustringsalgoritm inte vad den ser; allt den vet är att objekten liknar varandra.
Några användningsområden för klustringsalgoritmer är:
- Gruppera din e-postmarknadsföringslista i segment som beter sig på liknande sätt.
- Organisera en stor mängd böcker efter ämne.
- Gruppera foton efter objekten som finns i dem.
Generellt gäller att om du har en stor mängd objekt som du vill dela upp i olika grupper baserat på en specifik egenskap, är klustringsalgoritmer det du behöver.
Syntes
Slutligen har vi algoritmerna som kan skapa innehåll. Vi talar om AI-konstnärer, -författare och -musiker.
Användningsområdena för den här gruppen modeller är förmodligen oändliga – och modellerna (som nu kallas stora språkmodeller, eller "LLMs") blir bättre varje dag. Här är några exempel:
- Webbtextförfattare som skapar struktur och innehåll optimerat för SEO.
- Ta bort vattenstämpeln från en bild och rita den del av bilden som fanns under vattenstämpeln.
- Skapa nya bildrutor i ett spel i stället för att låta grafikkortet rendera dem, för att spara resurser.
- Generera foton till dina annonser som är fria från licensbegränsningar.
Här är ett exempel på en dikt som jag bad GPT-4 att skriva. (Obs! Jag ställde samma fråga till GPT-3 i januari och jag försäkrar dig om att den är mycket mer begåvad i dag.)
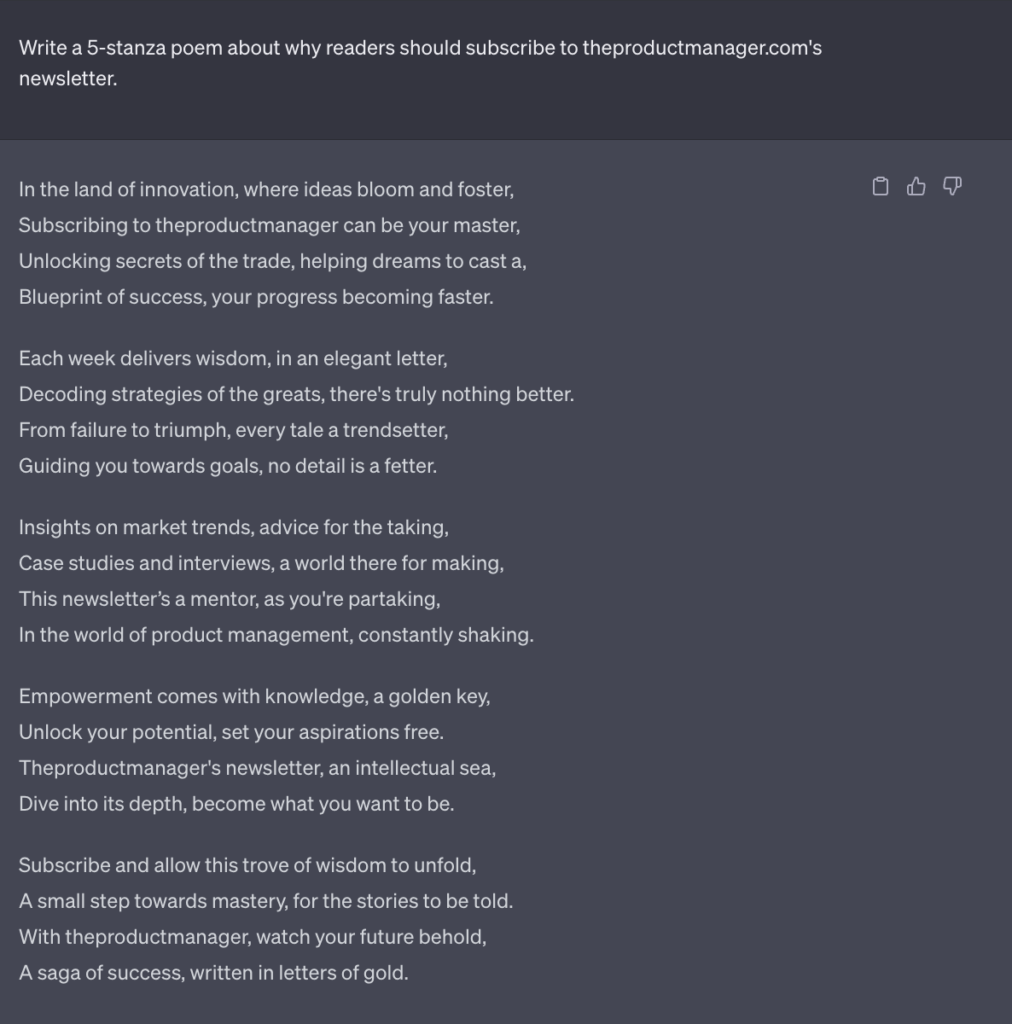
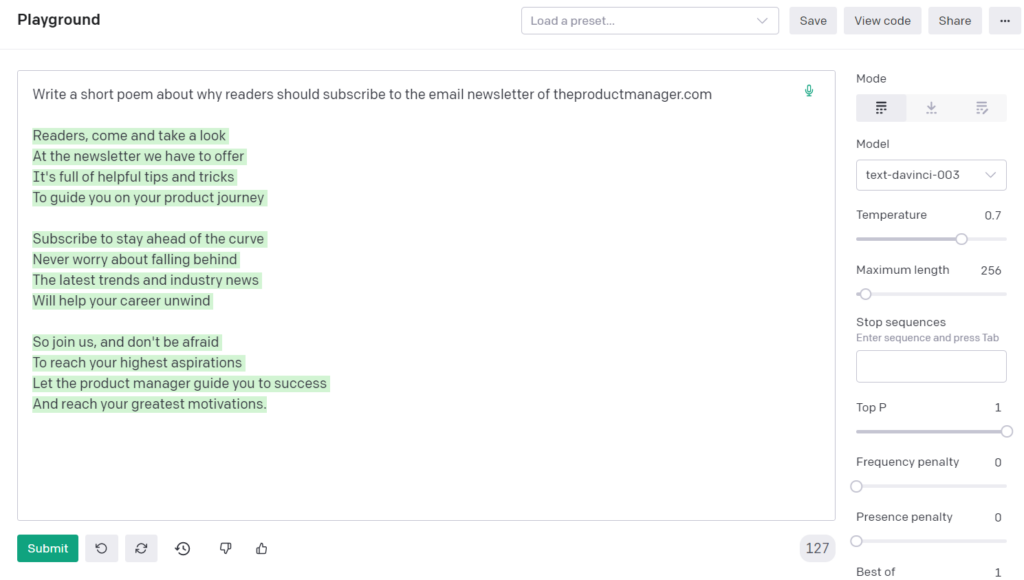
Du kan använda naturligt språk för att formulera en instruktion, och modellen kommer att förstå och uppfylla din begäran baserat på den kunskap den har samlat in från internet.
Sammanfattningsvis är detta de vanligaste typerna av tillämpningar för AI-modeller.
Det verkar som om det finns mycket du kan göra med AI, men ibland går det snabbare och blir billigare att överge idén om att bygga en modell och i stället använda enkel programvaruutveckling.
Uppgifter där du i stället bör använda vanlig programmering
Alla problem behöver inte lösas med en AI-modell.
För att avgöra om du kan lösa problemet utan AI kan du fråga dig själv om det finns en deterministisk och tydlig uppsättning regler eller åtgärder som du kan använda för att lösa det.
- Om svaret är ja kan du använda vanlig kod (kod är trots allt helt enkelt en uppsättning tydliga regler och kommandon till datorn). Du behöver till exempel inte AI för att avgöra om filen som dina användare har laddat upp är ett Excel-kalkylblad, eftersom XLSX-filer har en strikt struktur som du kan kontrollera.
- När du inte kan ange dessa tydliga regler behöver du förlita dig på AI-modeller för att hantera uppgiften åt dig. Det uppenbara exemplet här är bildigenkänning. Det finns ingen tillförlitlig uppsättning regler som kan hjälpa dig att förstå om den röda saken på bilden är en bil av ett visst märke.
För att ytterligare befästa detta koncept kan vi titta på flera problem som du kan lösa utan AI.
Hitta den kortaste vägen från punkt A till punkt B på kartan. Detta är ett välkänt problem inom matematiken, och det finns många deterministiska metoder (t.ex. Dijkstras algoritm) som kan lösa det med vanlig kod.
Kontrollera trafikstockningar på kartan. Den här uppgiften har en smart lösning. Google kan till exempel hämta GPS-data i realtid från alla smarttelefoner (där den här funktionen är aktiverad) och kontrollera om många telefoner står stilla på gatan. Om så är fallet måste det finnas en trafikstockning där.
Obs! Du kan dock använda AI här för att förutsäga en trafikstockning på en gata där det finns mycket få smarttelefoner eller där positionerna är utspridda.
Beräkna omnämnanden av varumärken i sociala medier. Om du vill få fram antalet omnämnanden av ditt varumärke på plattformar för sociala medier behöver du bara ett verktyg för datainsamling som läser sökresultat från sociala medier och räknar dem.
Obs! En AI-modell skulle här kunna vara användbar för att förutsäga antalet omnämnanden baserat på insamling av en liten del av resultaten (i stället för hela listan med sökresultat) – vilket sparar beräkningskapacitet och resurser.
Sammanfattningsvis är AI-modeller mycket kapabla när det gäller de uppgifter de kan utföra, men ibland är det enklare att skriva kod i stället.
Nu när du har förstått hur du använder artificiell intelligens i dina produkter vill jag gå vidare och dela med mig av några tips om hur man arbetar med AI-modeller.
6 tips för produktchefer som arbetar med maskininlärning
Under min karriär med arbete inom produkter baserade på maskininlärning har jag gjort många misstag som har lett till förlust av tid och pengar. För att säkerställa att du som ML-produktchef inte upprepar dessa misstag kommer här några användbara tips att tänka på.
Datakvaliteten avgör om dina modeller lyckas eller misslyckas
ML-teknikteam och datavetare älskar att använda uttrycket ”skräp in – skräp ut”. Det betyder att modellens kvalitet direkt beror på kvaliteten hos de dataset som du använder för att träna den.
För att förklara vad jag menar med dåliga data ska jag gå igenom några av de aspekter som avgör deras kvalitet:
Dåliga annoteringar: Annotering är processen att manuellt märka nya data som ”korrekta resultat” för modellens träning. Annotatörer för en modell som känner igen djur markerar till exempel varelsen på bilden och anger dess namn. Om du märker elefanter som ”pingviner” kommer din modell också att göra det efter träningen.
Brist på mångfald: Dina modeller fungerar bra endast om data från verkligheten liknar den data som de har tränats på. Om du har ett system för identifiering av registreringsskyltar som bara har lärt sig att läsa amerikanska registreringsskyltar kommer det att misslyckas totalt när det ser en bil med EU-skyltar.
Partiskhet i data: Har du någonsin hört talas om rasistisk AI? Google har nyligen bett den afroamerikanska befolkningen om ursäkt eftersom deras datorseendealgoritm gjorde följande:
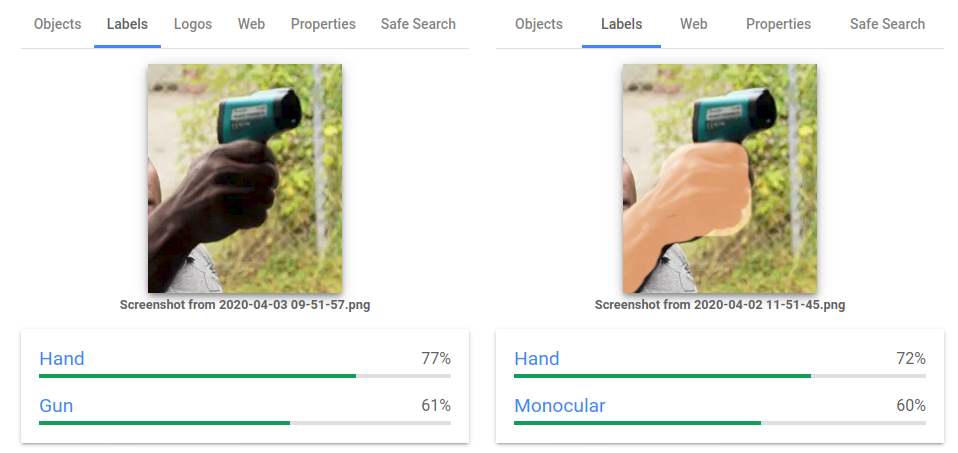
Det finns också många fall där polisens AI-modeller riktar in sig på minoriteter.
Anledningen är partiska data. Dessa polisrelaterade AI-system hade använt databasen från en polisstation som var ökänd för att vara rasistiskt partisk. Därför fanns det mycket data om gripanden av minoriteter, vilket ledde till att AI-modellen riktade in sig på dem.
Se därför till att de data du använder inte innehåller någon partiskhet som potentiellt kan leda till respektlöshet, kränkningar eller något värre.
Bygg funktioner som hjälper dig att träna om dina modeller
Att bygga modeller är halva arbetet – du behöver också ständigt förbättra dem genom att lägga till nya funktioner eller helt enkelt ge dem nya data att träna om på.
Att hitta data för omträning som är relevant för din ML-produkt kan vara en utmaning. Överväg därför att lägga till funktioner som gör det möjligt för dig att hämta dessa data från själva produkten.
Här är två metoder för återkopplingsloopar som jag har provat (och som fungerade bra):
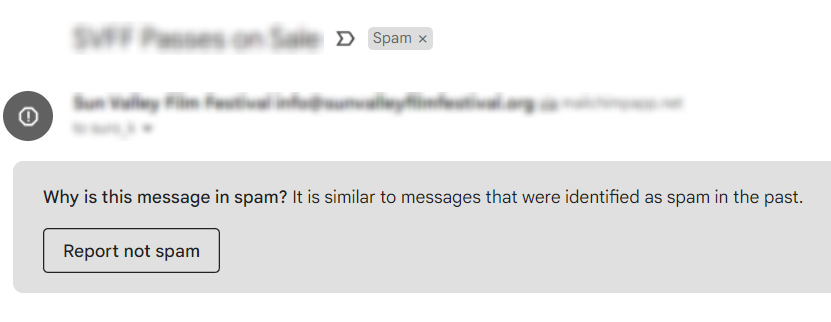
Be om återkoppling på AI-resultaten: Om du upptäcker skräppost i e-post kan du lägga till en knapp för ”inte skräppost” så att användarna kan ta bort e-postmeddelandet från skräpposten. Som ett resultat av denna åtgärd kommer de också att ”annotera” e-postmeddelandet som fritt från skräppost, och du kan använda det för att träna om din modell.
Obs! Ja, det är precis det som knappen ”Rapportera som inte skräppost” gör i Gmail.
Erbjud användaren att finjustera din modell med sina data: Det här är en situation som gynnar båda parter. Dina användare får en modell som presterar bättre eftersom du har tränat om den med deras specifika data, samtidigt som du får ytterligare data för att öka mångfalden i din modell.
Använd om möjligt färdiga lösningar i stället för att bygga egna
Du behöver inte uppfinna AI-hjulet på nytt. Det finns gott om färdiga modeller som du kan köpa eller hyra. Detta är särskilt relevant om du försöker lösa ett problem som är relativt vanligt (t.ex. att identifiera nakenbilder i din app för sociala medier).
Du kan hitta färdiga modeller på plattformar som Modelplace och RapidAPI Hub.

En enkel sökning efter en modell för logotypidentifiering gav oss nio färdiga lösningar som vi kan integrera med hjälp av API.
Använd (och bidra till) AI-modeller med öppen källkod
Artificiell intelligens har en betydande gemenskap kring öppen källkod. Du kan dra nytta av den för att hitta antingen färdiga modeller eller användbara verktyg som hjälper dig att bygga dina modeller.
Du kan ta en titt på den här listan på GitHub över några av de bästa projekten och initiativen inom maskininlärning med öppen källkod. Listan är mycket varierad och innehåller:
- Modeller med olika nivåer av förklarbarhet (hur väl du kan förklara hur din modell fungerar), skrivna i Python och C av jättar som IBM och Amazon.
- Träningsdata för dina modeller.
- Verktyg för dataanalys, uppföljning av nyckeltal, avvikelsedetektering och mycket mer.
Obs! Om du har gjort några förbättringar av dessa modeller kan du skicka in en kodändringsförfrågan och dela ditt arbete med gemenskapen kring öppen källkod och dess intressenter. Öppen källkod handlar om fantastiska människor som gör fantastiska saker och delar dem med andra.
More Articles
Det tar tid att bygga AI-modeller
Agila metoder och MVP fungerar inte alltid med ML-system. Du kan inte alltid bygga en liten modell och sedan lägga till nya funktioner ovanpå den genom flera iterationer. Ibland innebär en liten förändring av en modell att den måste tränas om från grunden.
Du kan till och med hamna i en situation där en optimering av modellen med 10 % innebär att du måste överge den gamla modellen och skapa en ny maskininlärningsalgoritm.
En annan sak att ta hänsyn till är det specifika arbetet som utförs av yrkesverksamma inom datavetenskap eller av tvärfunktionella team som har sådana specialister ombord.
Ibland kan de inte ge dig en uppskattning av när de kommer att slutföra sitt arbete, eftersom de tillbringar större delen av sin tid med att uppfinna något helt nytt och inte har någon aning om hur lång tid utvecklingsprocessen kommer att ta. (Ett bra exempel på detta är den ständigt föränderliga tidsplanen för Googles lansering av Gemini.)
Undvik drastiska förändringar i databasens struktur
Det här är en smärtsam verklighet som jag har stött på ett par gånger.
Om du använder dina egna data för att träna om dina modeller bör du undvika att ändra databasens struktur.
Dina modeller kommer att byggas för att hantera data med en specifik struktur och typ, och om ditt datateknikteam ändrar dina databaser måste ditt ML-team ändra dina modeller och kanske till och med träna om dem från grunden.
Lärande är en pågående process.
Artificiell intelligens har gjort världen till en bättre plats för oss alla, eftersom den har gjort det möjligt för många visionära grundare och ML-produktchefer att lösa problem som tidigare verkade omöjliga.
Jag hoppas att den här guiden har hjälpt dig att förstå konceptet AI inom produktledning, produktchefens roll i denna process samt de verkliga sätt som företag kan använda AI på.
Men att bygga fantastiska nya produkter handlar inte bara om korrekt användning av AI. Det finns många andra viktiga produktaspekter som du också bör behärska, bland annat:
- Konsten att bygga minimala livskraftiga produkter.
- Att planera teamets arbete på rätt sätt med hjälp av produktfärdplaner.
- Att hitta din PMF på ett kostnadseffektivt sätt med mera.
Slutligen kan du, precis som dikten i GPT-3-demonstrationen antydde, prenumerera på vårt nyhetsbrev för att ta del av det bästa inom produktledning och ligga steget före.

