
Kunstig intelligens er sannsynligvis det heteste temaet i teknologiverdenen akkurat nå.
AI-drevne produkter blir enhjørninger eller sikrer seg hundrevis av millioner i risikokapital. Det finnes også kjente produktledere som leder disse AI-drevne produktene, og som vi følger og lærer av.
Mange produktledere der ute ønsker å dra nytte av denne utrolige teknologien, enten ved å lede et AI-produkt eller ved å legge til AI-funksjoner i de eksisterende produktene sine. Hvis du er en av dem, er dette til deg.
Jeg har utviklet flere AI-produkter, og jeg er her for å hjelpe deg med å forstå denne teknologien og få mest mulig ut av den.
Hva er maskinlæring?
Maskinlæring er en fagdisiplin som fokuserer på å lage algoritmer og programvare som er i stand til å «lære» av informasjonen vi gir dem, og som effektivt kan utføre bestemte typer oppgaver som følge av denne treningen.
Begrepet og selve fagfeltet er overraskende gammelt – det kan spores tilbake til 1959, da Arthur Samuel fra IBM (en av datidens fremtredende datavitere) introduserte det i arbeidet sitt «Noen studier innen maskinlæring ved bruk av damspillet.»
Til tross for sin 60 år lange historie har maskinlæring imidlertid blitt populært først i løpet av det siste tiåret, takket være den massive økningen i datakraft, spesielt i GPU-er.
Men hva har maskinlæring med kunstig intelligens å gjøre? La oss gå videre ved å avklare dette først.
Maskinlæring (ML) versus kunstig intelligens (AI)
Alle bruker begrepene «maskinlæring» og «kunstig intelligens» om hverandre for å beskrive den smarte programvaren som er i stand til å gjenkjenne elementer i bilder, skrive dikt og generere imponerende svar på detaljerte instruksjoner.
Kunstig intelligens er imidlertid det bredere konseptet som omfatter maskiner med evne til persepsjon og resonnering, mens maskinlæring er en delmengde av AI som fokuserer på programvare som kan lære.
Nå som vi har avklart begrepene, kan vi gå videre til å forstå hvordan disse maskinene lærer, og det grunnleggende ved hvordan de fungerer.
Slik fungerer maskinlæring

For å forstå maskinlæring bør vi først se på den vanligste formen – nevrale nettverk for dyp læring.
Et nevralt nettverk er en struktur skrevet i vanlig kode som forsøker å gjenskape funksjonen til en biologisk hjerne. Hos mennesker og andre levende skapninger er hjernen et komplekst nettverk av nevroner (nerveceller) som er koblet til hverandre, der en impuls fra én celle aktiverer en annen, og informasjonen beveger seg langs nettverket av nevroner.
Jeg tror ikke jeg er den rette personen til å forklare biologi (siden jeg ville mislyktes totalt), så jeg holder meg til teknologien.
De nevrale nettverkene i programvare ser omtrent slik ut:
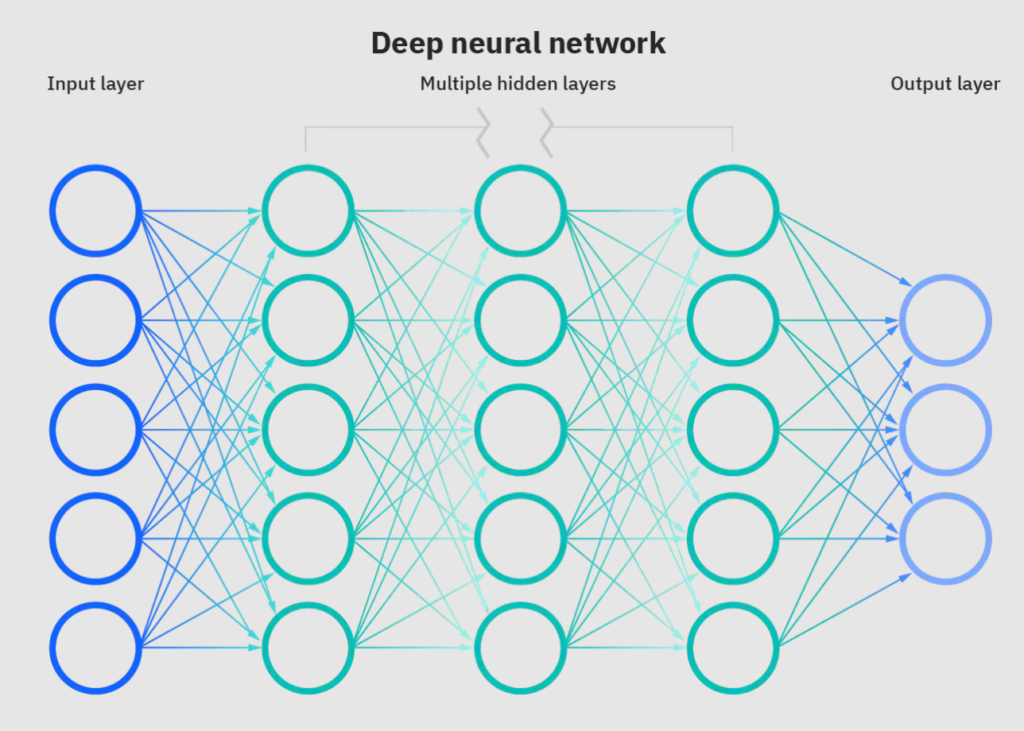
Hver sirkel her er ett enkelt nevron. I kode er et nevron ganske enkelt en funksjon som kan ta imot en form for informasjon, behandle den og sende et resultat videre til det neste nevronet.
Merk: Dette er en forenkling av den virkelige prosessen. Hvis du vil ha flere detaljer, kan du se den eksepsjonelle videoleksjonen om nevrale nettverk på YouTube-kanalen 3blue1brown, der de også forklarer de matematiske konseptene bak denne teknologien.
Som vi kan se på bildet ovenfor, er nevronene våre organisert i lag. Nevrale nettverk har vanligvis tre typer lag:
- Inndatalaget, som har ansvar for å ta imot informasjon fra omverdenen.
- De skjulte lagene behandler denne informasjonen, der hvert lag behandler ett enkelt aspekt av den.
- Utdatalaget gir det behandlede resultatet tilbake til omverdenen.
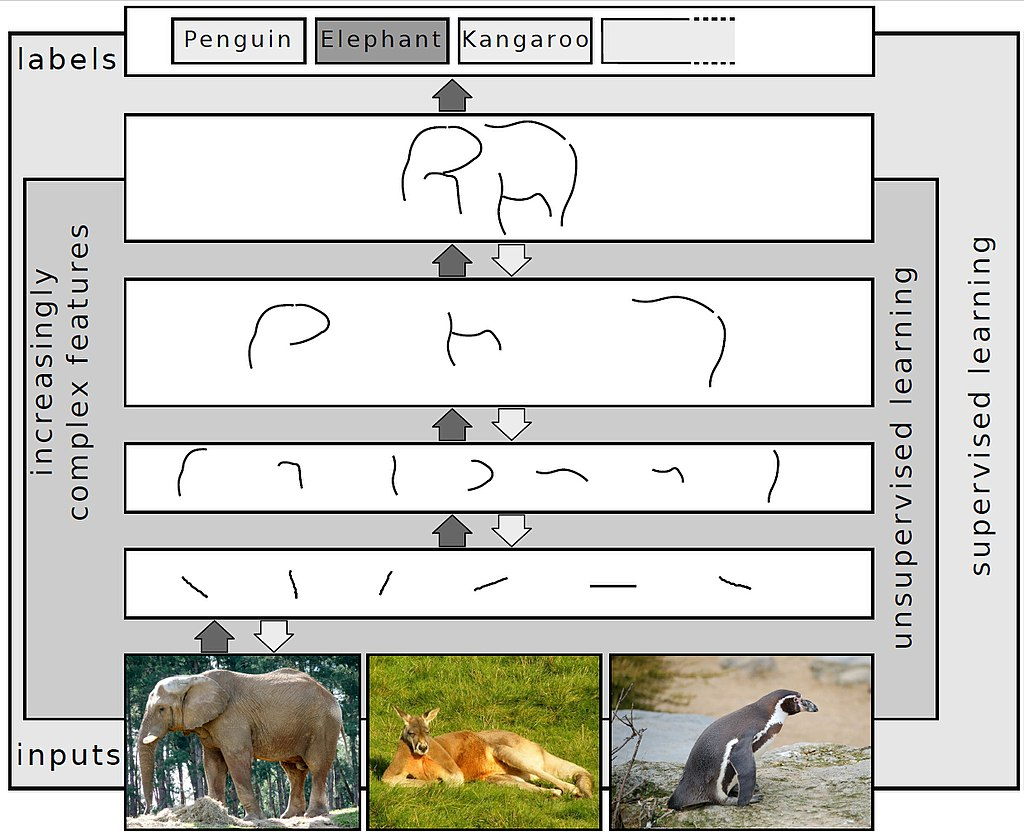
La oss nå forstå betydningen av disse lagene gjennom et enkelt eksempel. Tenk deg at du vil at det nevrale nettverket skal gjenkjenne et dyr på et bilde. For å gjøre dette har du utviklet et nevralt nettverk som består av seks lag, og som fungerer på følgende måte:
- Inndatalaget som tar inn små deler av bildet av dyret og sender dem videre til det første skjulte laget.
- Det første skjulte laget vil forsøke å finne grunnleggende former (f.eks. rette linjer) i hver del og sende denne informasjonen videre til det andre laget.
- Det andre laget vil deretter kombinere noen av disse linjene til grunnleggende geometriske former (f.eks. sirkler, halvsirkler osv.) og sende dem videre til det tredje laget.
- Det tredje laget vil deretter lage mer komplekse former ut fra disse geometriske formene.
- Det fjerde laget vil kombinere alle formene som er laget tidligere, og få frem omrisset av et dyr.
- Til slutt vil utdata-laget angi hvilken type dyr det har gjenkjent ut fra formen.
Slik vil det se ut visuelt.
Når du ser på prosessen ovenfor, lurer du kanskje på hvordan AI-ingeniører får disse lagene til å gjenkjenne former og gjette hvilket dyr som er på bildet, ikke sant? De gjør det ved å «trene» det nevrale nettverket til å utføre oppgaven sin.
For å trene nettverket gir AI-ingeniørene det et sett med inndata sammen med de tilsvarende korrekte utdataene. I vårt tilfelle ville dette være flere bilder av dyr som inndata, og de samme bildene med riktig dyretype som utdata.
Siden nettverket ditt har de riktige svarene, vil det kontinuerlig justere seg selv (parametrene som hvert nevron sender videre til andre) helt til svarene ligner svært mye på de riktige svarene vi har gitt.
I virkeligheten vil nettverket ditt aldri være 100 % nøyaktig i svarene sine, og det vil alltid være en viss grad av feil som du må ta hensyn til. Den gode nyheten er at du egentlig ikke ønsker at de skal være 100 % korrekte. Det eneste du bryr deg om, er at modellen er raskere og mer nøyaktig enn et menneske.
Nå som vi har forstått hvordan det fungerer, kan vi gå videre til å forstå hvordan du kan bruke maskinlæring i produktene dine.
Maskinlæring: Hva det kan gjøre, og hva det ikke kan gjøre

Hype-en rundt AI er enorm, og mange gründere eller produktledere i oppstartsbedrifter drømmer om å legge til AI i produktene sine. Men her er spørsmålet til en million dollar: Trenger du egentlig AI?
Jeg forstår at begrepet «AI-drevet» ser bra ut i investorpresentasjonen og markedsføringsmateriellet til ethvert produkt, men ikke glem at det er dyrt og tidkrevende å bygge en AI-modell.
Hvis AI-modellen din derfor har som mål å løse et grunnleggende problem som du enkelt kunne ha håndtert med vanlig kode, ender du opp med å sløse bort midlene dine på et prangende begrep på nettstedet ditt.
For å forstå om du trenger en AI-modell, kan vi se nærmere på oppgavene og problemene du kan håndtere med den, og sammenligne dem med dem du bør løse med vanlig programmering.
Have an account? Log In
Vanlige oppgaver som maskinlæringsmodeller kan håndtere for deg
ML-modeller er ikke magiske – selv om det, med alle måtene du kan bruke ChatGPT på og andre nye store språkmodeller, absolutt kan virke slik. Selv om vi ser en økning i avanserte AI-verktøy, kan mange produkter dra nytte av enklere ML-modeller.
Funksjonen disse modellene utfører, vil vanligvis falle inn under disse fire kategoriene.
Klassifisering
Som navnet antyder, kan disse modellene gjenkjenne informasjonen du gir dem, og klassifisere den eller tilordne informasjonen en etikett. Eksempelet med å gjenkjenne dyr fra bildet som vi diskuterte tidligere, er et typisk tilfelle av AI-klassifisering.
AI-klassifisering deles på sin side inn i fire typer:
Binær klassifisering: Denne modellen gir deg et ja eller et nei. Vanlige bruksområder er detektorer for søppelpost i e-post (isSpam = true eller false), diagnostisering av brystkreft (risikofylt eller ikke risikofylt) osv.
Ubalansert klassifisering: Disse modellene deler data inn i to grupper – normal majoritet og unormal minoritet. Et eksempel på dette er svindeloppdagelse i tolldeklarasjoner ved landegrenser.
AI-modellen undersøker dokumentene og gir hvert tolldeklarasjonsskjema et grønt (klart), gult (dokumentene må kontrolleres) eller rødt (varene må kontrolleres) flagg, avhengig av hvor «normale» dokumentene ser ut sammenlignet med andre.
Flerklasseklassifisering: I dette tilfellet vil modellen velge én av mange forhåndsdefinerte verdier. Algoritmer for optisk tegngjenkjenning (de som trekker ut tekst fra et bilde) tilhører denne typen.
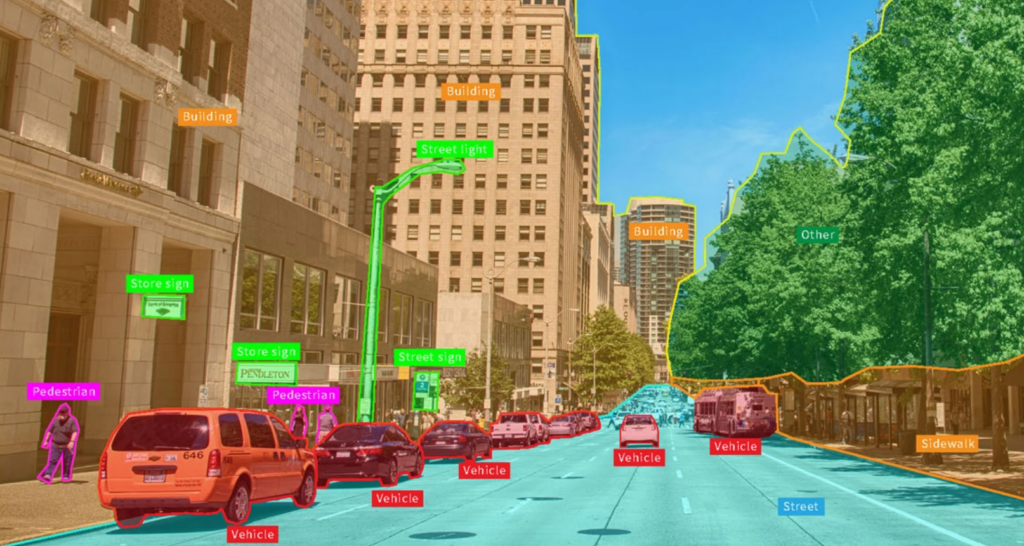
Fleretikettklassifisering: I motsetning til den forrige typen vil disse modellene tilordne flere etiketter til samme datastykke. Mange algoritmer innen datamaskinsyn faller inn under denne kategorien, ettersom de ser på bildet eller videoen og identifiserer flere objekter i den. Slik ser fleretikettklassifisering ut for en selvkjørende bil.
Andre bruksområder for denne teknologien omfatter å trekke ut nyttig informasjon fra teksten (f.eks. meninger om merkevaren din fra Twitter-meldinger) eller å fastslå temaene som diskuteres i en podkast.
Regresjon
Denne klassen av KI-modeller kan gjøre prediksjoner basert på eksisterende informasjon. Med regresjonsmodeller kan du forstå forholdet mellom flere faktorer og forutsi fremtidige verdier basert på tidligere verdier (også kalt prognosealgoritmer).
Noen av bruksområdene for regresjonsalgoritmer omfatter:
- Prognostisering av aksjekurs basert på tidligere prissvingninger.
- Prediksjon av prisen på en bil basert på kjørelengde, produksjonsår osv.
- Forslag til de beste annonsetekstene for bedre konverteringsrater.
- Finne den beste ukedagen og tiden for å sende e-poster for å få flest åpninger og klikk.
Noen av de større modellene kan også forutsi ting som er så komplekse og kaotiske som været.
Klynging
Dette er en prosess basert på ikke-veiledet læring, der modellen oppdager likheter i et sett med elementer og grupperer dem etter denne likheten. I motsetning til klassifisering vet en klyngealgoritme ikke hva den ser på; alt den vet, er at disse elementene ligner på hverandre.
Noen av bruksområdene for klyngealgoritmer er:
- Gruppere e-postmarkedsføringslisten din i segmenter som oppfører seg på lignende måte.
- Organisere et stort utvalg bøker etter tema.
- Gruppere bilder etter elementene som finnes i dem.
Generelt gjelder det at hvis du har et stort sett med elementer som du vil dele inn i ulike grupper basert på en bestemt egenskap, er det klyngealgoritmer du trenger.
Syntese
Til slutt har vi algoritmene som kan skape innhold. Vi snakker om KI-kunstnere, -forfattere og -musikere.
Bruksområdene for denne gruppen modeller er sannsynligvis uendelige – og modellene (nå omtalt som store språkmodeller, eller «LLM-er») blir bedre hver dag. Her har du:
- Tekstforfattere for nettsteder som lager struktur og innhold optimalisert for SEO.
- Fjerne vannmerket fra et bilde og tegne den delen av bildet som lå under vannmerket.
- Opprette nye bilder i et spill i stedet for å la grafikkortet gjengi dem, for å spare ressurser.
- Generere bilder til annonsene dine som er lisensfrie.
Her er et eksempel på et dikt jeg ba GPT-4 om å skrive. (Merk: Jeg stilte GPT-3 det samme spørsmålet i januar, og jeg forsikrer deg om at den er langt mer talentfull i dag.)
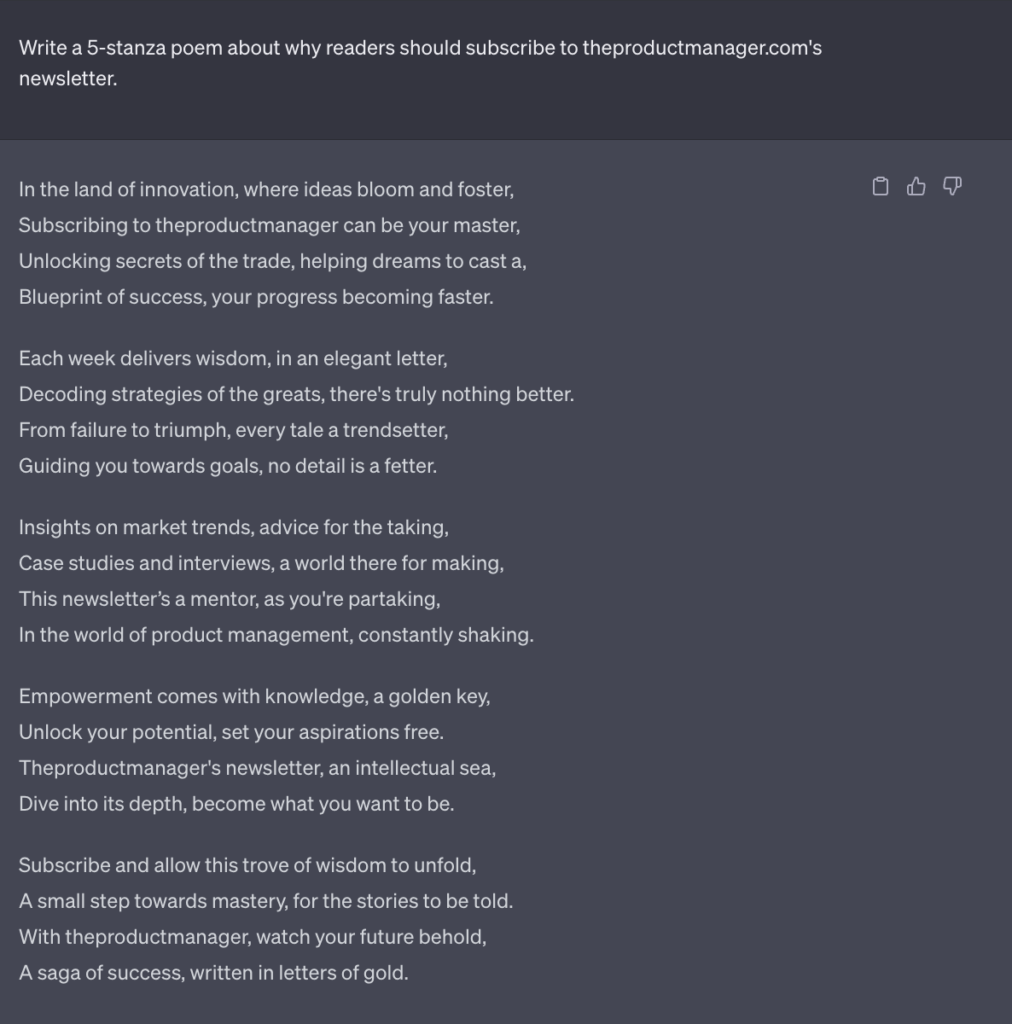
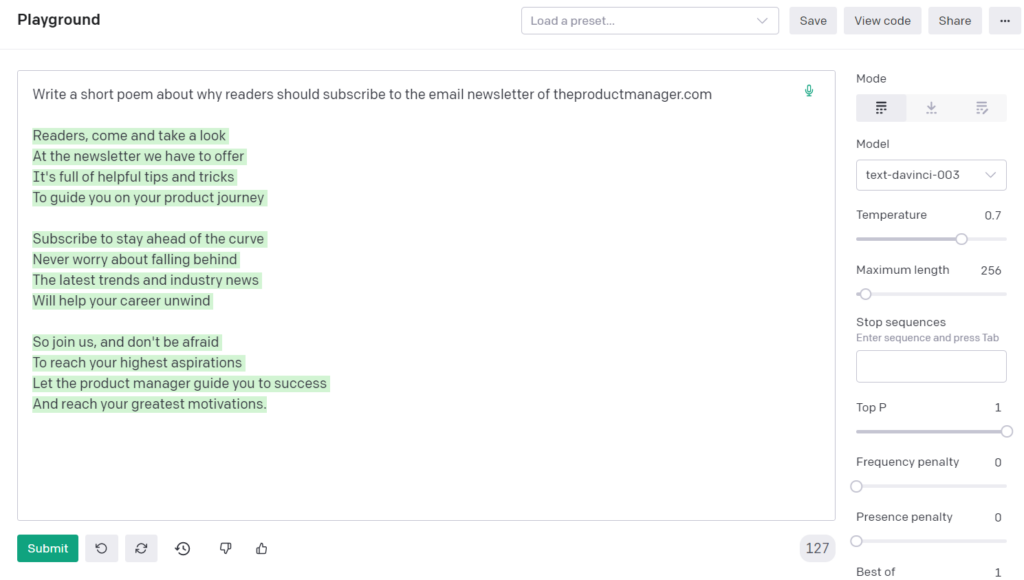
Du kan bruke naturlig språk til å formulere en ledetekst, og modellen vil forstå og oppfylle forespørselen din basert på kunnskapen den har samlet inn fra internett.
For å oppsummere er dette de vanligste typene bruksområder for KI-modeller.
Det ser ut til at det er mye du kan gjøre med KI, men noen ganger er det raskere og billigere å droppe ideen om å bygge en modell og heller ty til enkel programvareutvikling.
Oppgaver der du heller bør bruke vanlig programmering
Ikke alle problemer trenger en KI-modell for å løses.
For å avgjøre om du kan løse problemet du står overfor uten KI, kan du spørre deg selv om det finnes et deterministisk og tydelig sett med regler eller handlinger du kan følge for å løse det.
- Hvis svaret er ja, kan du bruke vanlig kode (tross alt er kode ganske enkelt et sett med tydelige regler og kommandoer til datamaskinen). Du trenger for eksempel ikke KI for å avgjøre om filen brukerne dine har lastet opp, er et Excel-regneark, siden XLSX-filer har en streng struktur som du kan kontrollere.
- Når du ikke kan peke på disse tydelige reglene, må du stole på KI-modeller for å håndtere oppgaven for deg. Det åpenbare eksempelet her er bildegjenkjenning. Det finnes ikke noe pålitelig sett med regler som kan hjelpe deg å forstå om den røde gjenstanden på bildet er en bil av et bestemt merke.
For å tydeliggjøre dette konseptet ytterligere kan vi se på flere problemer som du kan løse uten KI.
Finne den korteste ruten fra punkt A til punkt B på kartet. Dette er et velkjent problem innen matematikk, og det finnes mange deterministiske fremgangsmåter (f.eks. Dijkstras algoritme) som kan løse det med vanlig kode.
Kontrollere trafikkorker på kartet. Denne har en smart løsning. Google kan for eksempel hente sanntidsdata om GPS-posisjonen til alle smarttelefoner (der denne funksjonen er aktivert) og kontrollere om mange telefoner står stille i gaten. Hvis det er tilfelle, må det være trafikkork der.
Merk: Du kan imidlertid bruke KI her til å forutsi trafikkork i en gate der det finnes svært få smarttelefoner, eller der posisjonene er spredt.
Beregne omtaler av merkevarer i sosiale medier. Hvis du vil finne antallet omtaler av merkevaren din på sosiale medieplattformer, trenger du bare et skrapeverktøy som leser søkeresultater fra sosiale medier og teller dem.
Merk: En KI-modell ville vært nyttig her for å forutsi antallet omtaler basert på skraping av en liten del av resultatene (i stedet for hele listen over søkeresultater) – noe som sparer datakraft og ressurser.
For å oppsummere er KI-modeller ganske kapable når det gjelder oppgavene de kan utføre, men noen ganger er det enklere å kode i stedet.
Nå som du har fått en forståelse av hvordan du bruker kunstig intelligens i produktene dine, vil jeg gå videre og dele et par tips om hvordan du kan arbeide med KI-modeller.
6 tips til produktledere som arbeider med maskinlæring
Gjennom min karriere med arbeid med maskinlæringsprodukter har jeg gjort mange feil som har ført til tap av tid og penger. For å sikre at du som produktleder for maskinlæring ikke gjentar disse feilene, får du her noen nyttige tips du bør ta hensyn til.
Kvaliteten på dataene vil være avgjørende for modellene dine
Team innen maskinlæringsteknikk og dataforskere liker å bruke uttrykket «søppel inn – søppel ut». Det betyr at kvaliteten på modellen vil avhenge direkte av kvaliteten på datasettene du bruker til å trene den.
For å forklare hva jeg mener med dårlige data, skal jeg gå gjennom noen av aspektene som avgjør kvaliteten:
Dårlige annoteringer: Annotering er prosessen med å merke nye data manuelt for å bruke dem som «korrekte resultater» i treningen av modellen. Annotatorer for en modell som gjenkjenner dyr, vil for eksempel fremheve dyret på bildet og merke det med navnet. Hvis du merker elefanter som «pingviner», vil modellen din gjøre det samme etter treningen.
Mangel på mangfold: Modellene dine vil bare fungere godt hvis dataene fra den virkelige verden ligner på dataene de er trent på. Hvis du har et system for registreringsskiltgjenkjenning som bare har lært å lese amerikanske registreringsskilt, vil det mislykkes totalt når det ser en bil med EU-skilt.
Skjevheter i dataene: Har du noen gang hørt om rasistisk KI? Google har nylig beklaget overfor det afroamerikanske samfunnet fordi datasynalgoritmen deres gjorde dette:
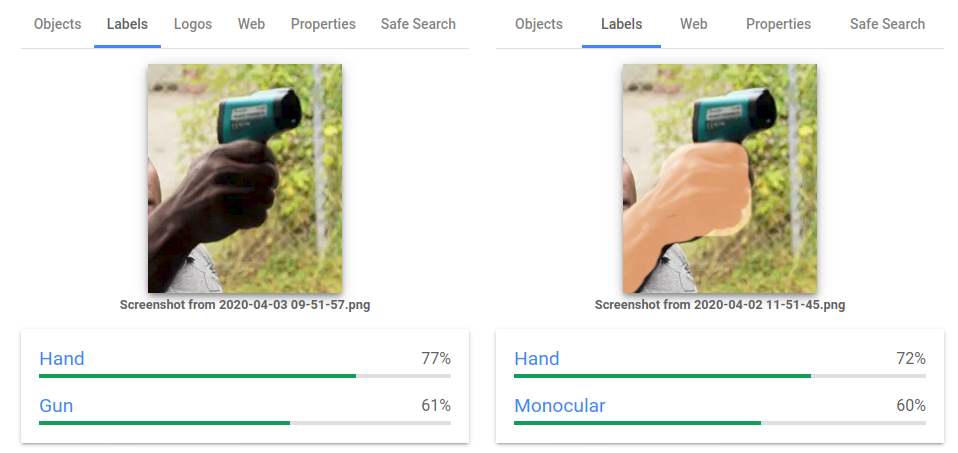
Det finnes også en rekke tilfeller der politiets KI-modeller retter seg mot minoriteter.
Årsaken til dette er skjeve data. Disse politi-KI-ene hadde brukt databasen til en politistasjon som var beryktet for å være rasistisk partisk. Dermed fantes det mye data om arrestasjoner av minoriteter, noe som førte til at KI-modellen rettet seg mot dem.
Sørg derfor for at dataene du bruker, ikke inneholder skjevheter som potensielt kan føre til respektløshet, krenkelser eller noe verre.
Bygg funksjoner som hjelper deg med å trene modellene dine på nytt
Å bygge modeller er halve jobben – du må også stadig forbedre dem ved å legge til nye funksjoner eller ganske enkelt gi dem nye data som de kan trenes på nytt med.
Det kan være utfordrende å finne data til omtrening som er relevante for ML-produktet ditt. Vurder derfor å legge til funksjoner som gjør det mulig å hente disse dataene fra selve produktet.
Her er to tilnærminger til tilbakemeldingssløyfer som jeg har prøvd (og som fungerte godt):
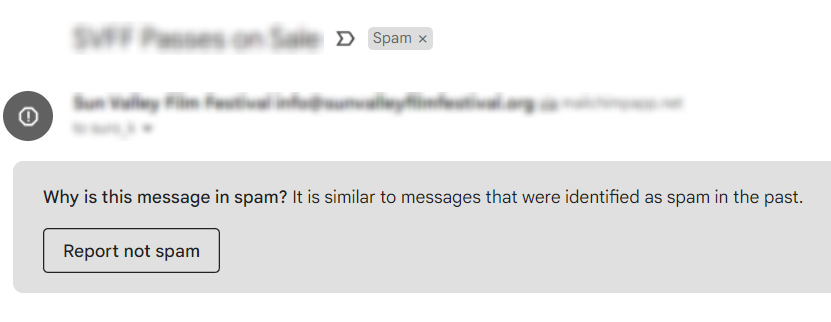
Be om tilbakemelding på AI-resultatene: Hvis du oppdager søppelpost i e-post, kan du legge til en «ikke søppelpost»-knapp som brukerne kan trykke på for å fjerne e-posten fra søppelpostmappen. Som et resultat av denne handlingen vil de også «annotere» e-posten som fri for søppelpost, og du kan bruke den til å trene modellen på nytt.
Merk: Ja, det er akkurat dette knappen «Rapporter som ikke søppelpost» gjør i Gmail.
Tilby brukeren å finjustere modellen din med utgangspunkt i egne data: Dette er en vinn-vinn-situasjon. Brukerne dine får en modell som yter bedre fordi du har trent den på nytt med utgangspunkt i deres spesifikke data, mens du får ekstra data som kan øke mangfoldet i modellen.
Bruk ferdige løsninger i stedet for å bygge dine egne, hvis du kan
Du trenger ikke å finne opp AI-hjulet på nytt. Det finnes mange ferdigtrente modeller der ute som du kan kjøpe eller leie. Dette er særlig relevant hvis du prøver å løse et problem som er relativt vanlig (for eksempel å identifisere nakenbilder i en app for sosiale medier).
Du kan finne ferdigtrente modeller på plattformer som Modelplace og RapidAPI Hub.
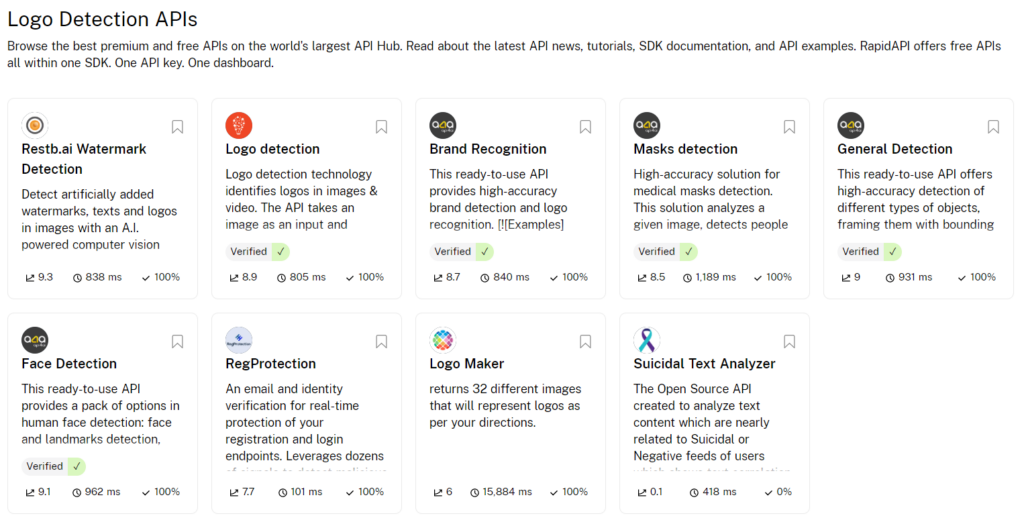
Et enkelt søk etter en modell for logogjenkjenning ga oss 9 ferdige løsninger som vi kan integrere ved hjelp av API.
Bruk og bidra til AI-modeller med åpen kildekode
Kunstig intelligens har et betydelig fellesskap rundt åpen kildekode. Du kan dra nytte av dette for å finne enten ferdigtrente modeller eller nyttige verktøy som kan hjelpe deg med å bygge modellene dine.
Du kan ta en titt på denne listen på GitHub over noen av de beste prosjektene og initiativene innen maskinlæring med åpen kildekode. Listen er ganske mangfoldig og inkluderer:
- Modeller med ulike nivåer av forklarbarhet (hvor godt du kan forklare hvordan modellen fungerer), skrevet i Python og C, fra giganter som IBM og Amazon.
- Treningsdata for modellene dine.
- Verktøy for dataanalyse, sporing av nøkkeltall, avviksdeteksjon og mer.
Merk: Hvis du har gjort forbedringer i disse modellene, kan du sende inn en forespørsel om å få endringene innlemmet og dele arbeidet ditt med fellesskapet rundt åpen kildekode og interessentene deres. Åpen kildekode handler om fantastiske mennesker som gjør fantastiske ting og deler dem med andre.
More Articles
Det tar tid å bygge AI-modeller
Metodikkene Smidig og MVP fungerer ikke alltid med ML-systemer. Du kan ikke alltid bygge en liten modell og deretter legge til nye funksjoner oppå den gjennom flere iterasjoner. Noen ganger vil en liten endring i en modell innebære at den må trenes på nytt fra grunnen av.
Du kan til og med komme i en situasjon der en forbedring av modellen på 10 % innebærer at du må forkaste den gamle modellen og lage en ny maskinlæringsalgoritme.
En annen ting du bør ta hensyn til, er hvor spesifikt arbeidet til fagfolk innen datavitenskap eller tverrfunksjonelle team som har slike fagfolk med på laget, er.
Noen ganger vil de ikke kunne gi deg et estimat på når de blir ferdige med arbeidet, fordi de bruker mesteparten av tiden på å finne opp noe helt nytt, og ikke har noen anelse om hvor lang tid utviklingsprosessen vil ta. (Et godt eksempel på dette er den stadig skiftende tidsplanen for lanseringen av Googles Gemini.)
Unngå drastiske endringer i databasestrukturen
Dette er en smertefull realitet som jeg har opplevd et par ganger.
Hvis du bruker dine egne data til å trene modellene dine på nytt, bør du unngå å endre strukturen i databasen.
Modellene dine vil bygges for å bruke data med en bestemt struktur og type, og hvis datateknikkteamet ditt endrer databasene, må ML-teamet ditt endre modellene og kanskje til og med trene dem på nytt fra grunnen av.
Læring er en kontinuerlig prosess.
Kunstig intelligens har gjort verden til et bedre sted for oss alle, fordi den har gjort det mulig for mange visjonære gründere og ML-produktledere å løse problemer som tidligere virket umulige.
Jeg håper at denne veiledningen har hjulpet deg med å forstå konseptet AI i produktledelse, produktlederens rolle i denne prosessen, samt de praktiske måtene virksomheter kan bruke AI på.
Men å utvikle flotte, nye produkter handler ikke bare om riktig bruk av AI. Det er også mange viktige produktelementer du bør beherske, blant annet:
- Kunsten å utvikle minimum levedyktige produkter.
- Planlegge teamets arbeid på en god måte med produktveikart.
- Finne din PMF på en kostnadseffektiv måte, osv.
Til slutt kan du, slik diktet i GPT-3-demoen antydet, abonnere på vårt nyhetsbrev for å få det beste innen produktledelse og ligge i forkant.